HNSWベクトル索引:階層探索と精度・メモリのトレードオフ
異なる距離尺度の近接グラフをたどるHNSWの仕組みと、実装ごとのM・ef設定が品質と資源に与える影響を説明します。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
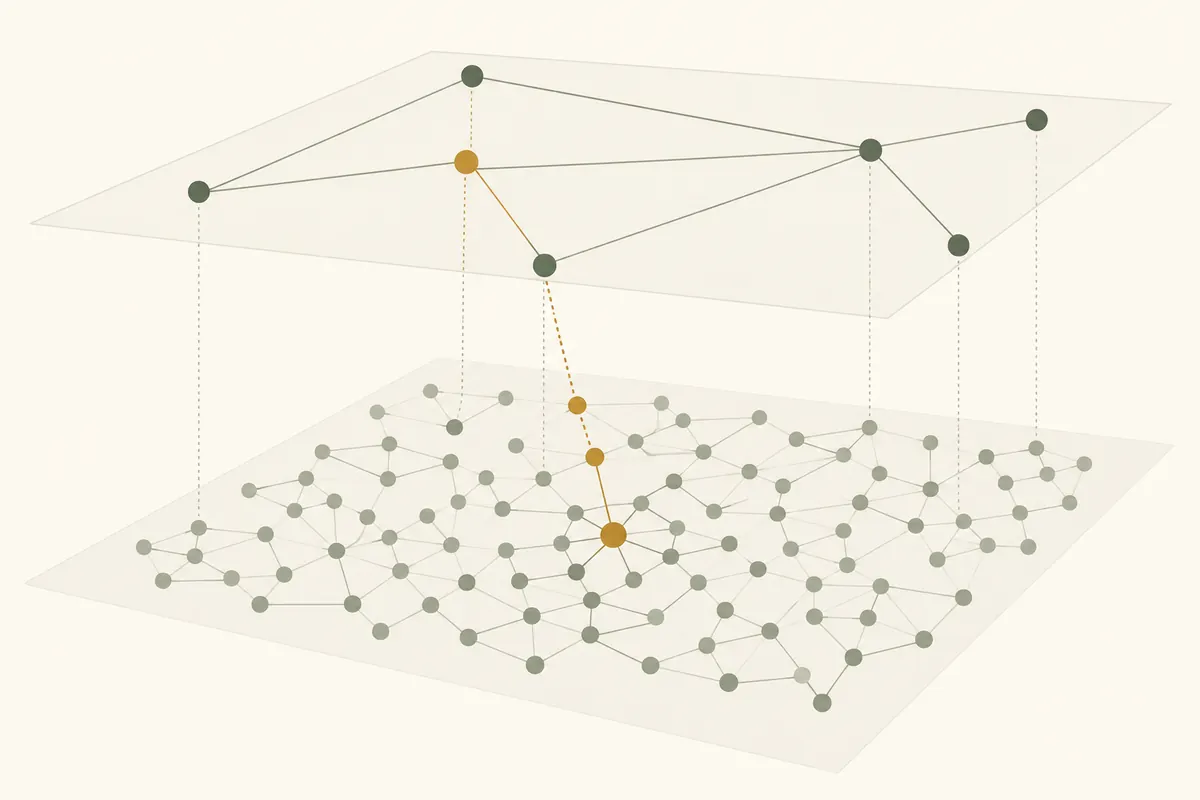
ベクトル検索はクエリに近いデータを探します。件数が多いと全項目の距離を計算するコストが高くなるため、近似最近傍(ANN)索引を使うことがあります。HNSWは複数階層の近接グラフで広い領域から候補を絞ります。近似結果は設定やデータによって厳密な上位K件と異なる場合があります。
階層ごとにリンクの距離尺度を分ける
MalkovとYashuninの論文では各項目をノードとし、近い項目を接続します。すべてのノードは最下層にあり、一部は確率的に上層にも含まれます。最高階層は指数的に減る確率で選ぶため、上層ほどノードが少なくなります。上層では長距離のリンクを使い、下層では近くの接続を詳しく調べます。
高速道路と街路の比喩なら、上層は関連領域に向かい、下層は周辺候補を絞ります。ただし最短経路や厳密な近傍を保証するものではありません。論文の計算量や性能は提案方式と評価結果の主張で、あらゆる次元、分布、距離尺度、機器で同じ結果になる保証ではありません。
クエリは候補を絞りながら下層へ進む
検索は上層の入口から始まり、クエリに近い隣接ノードをたどります。その層で候補が改善しなくなると下へ進み、前層の有望候補を新しい入口として使います。最下層では候補を広めに調べてK件を選びます。有用なグラフがあれば全ベクトルを毎回比較せず近い領域を探せます。
計算と候補を制限するため近似誤差が起こり得ます。リンクが疎、データが強くクラスタ化、距離尺度が用途に合わない場合は必要な近傍を見落とすことがあります。埋め込みモデル、正規化、距離関数、フィルターも解釈に影響します。HNSWは検索索引であり、埋め込みの意味や結果の業務上の有用性を検証しません。
Mとefは実装ごとの調整項目
論文は構築と検索でグラフ接続や候補幅を調整する変数を説明します。hnswlibはM、ef_construction、検索時のefを公開しています。同ライブラリの文書ではMはメモリに強く影響し、精度や実行時間にも関係し得ます。ef_constructionは構築時の探索特性を調整し、検索efを大きくすると候補が増え精度や再現率が向上し得る一方、検索は遅くなります。
これはhnswlibの説明で、すべてのライブラリが同じ既定値や意味を持つわけではありません。保存方式、接続上限、並列構築、フィルター対応も異なり得ます。hnswlib READMEのefはKより大きくするという記述も同APIの案内であり、HNSW全体の規格ではありません。実データと代表クエリを使い厳密検索結果と比べます。
速度と品質を一緒に測る
検索時間だけで索引を評価しません。厳密な近傍を基準に再現率を測り、遅延分布、メモリ、構築時間、更新、フィルター動作も記録します。平均値が良くても、まれなクエリや小さな群で見落としが増えることがあります。モデルやデータ分布が変わったら前の設定を信頼し続けず再測定します。
Mや候補幅は自動的に品質を高める設定ではなく、計算資源とのトレードオフです。論文の対数的な計算量は提案方式の分析であり、サービスの遅延保証ではありません。再現可能な比較では、実際のクエリ分布を代表する正解標本と関連候補の判定基準を定めます。埋め込みと距離の定義をそろえ、データ、距離尺度、機器、並行度、索引版、再現率、メモリ、構築時間、遅延分布、遅い応答の割合を記録してください。フィルター後に候補が少ないクエリは別の群として扱います。平均値に隠れる特定群の再現率や遅延の裾への影響を判断しやすくなります。