UTF-8のchunk境界でTextDecoderのエラーを扱う
streamオプションで分割されたネットワークchunk間のデコーダ状態を保ち、最後にflushして不正データを処理します。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
ネットワークのchunk境界は文字の境界と一致するとは限りません。UTF-8の1文字が複数chunkに分かれると、各部分を個別にデコードして文字が壊れることがあります。Encoding StandardとMDNのTextDecoder.decode()資料で動作を確認できます。
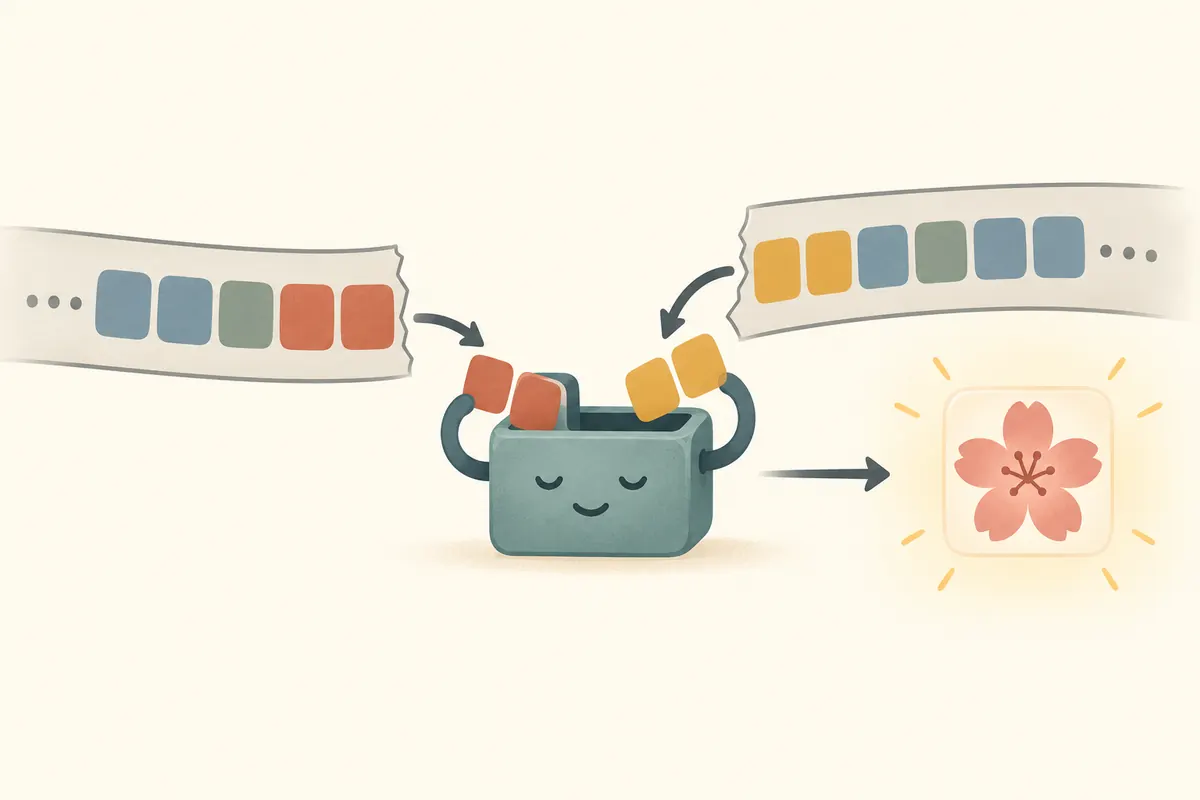
概念図であり、実リクエストやbyte取得結果ではありません。
decoderをchunk間で使い続ける
一つのTextDecoderを使い、最後ではないchunkごとにdecode(bytes, {stream:true})を呼びます。不完全な末尾バイト列の状態が次の入力へ引き継がれます。stream:trueがなければ各入力を完結したものとして扱うため、chunkごとにdecoderを作ると状態を失います。ReadableStream.pipeTo() referenceはストリーム終了とエラー伝播の背景を示します。
入力終了時にflushする
正常に入力が終わったらdecoder.decode()を追加で一度呼び、残った状態をflushします。最後の呼び出しを省くと未完了シーケンスを処理できません。既定のfatal:falseでは不正入力が置換文字になる場合があります。fatal:trueならデコードエラーが例外となり、呼び出し側で不正データを拒否できます。
1バイト1置換と断定しない
replacement動作で出力される置換文字の数は、不正シーケンスの形によって異なります。不正バイトごとに必ず1文字と説明しないでください。別のparser、署名対象、重要な処理へ渡すテキストでは、許容する入力を決め、fatalモードや追加検査が必要か検討します。
TextDecoderStreamを使う場面
TextDecoderStreamはReadableStreamのbyte chunkを文字列chunkに変換しながら境界を処理します。正常終了時に未完了状態をflushし、fatalエラーはストリームをエラーにする場合があります。対応ブラウザーと取消・エラー伝播を確認してください。後段でchunkを順次消費する場合に適し、応答全体を先にbufferへ読み込んでいるなら導入効果は限られます。
読み取り中は同じdecoderを使う
response body readerからUint8Arrayを受け取り、同じdecoderへ順に渡し、readerがdoneになったらdecode()を一度呼びます。デコード後の文章を行単位で読む場合も、byte chunkがUTF-8文字や改行の境界と一致するとは限らないため、末尾の文字列断片を次の結果へつなぎます。これはAPIの流れの説明で、実リクエストを実行した主張ではありません。
読み取りが正常EOFではなく取消または失敗で終わった場合、最後のflushを完了文書として扱わないでください。診断ログには終了理由、最後のdecode()を呼んだか、fatal:trueの例外が出たかを分けて記録すると、通信中断とデコード失敗を切り分けやすくなります。部分データを再試行・破棄・報告する方針を決め、変換ストリームではpipeTo()のエラーや取消の伝播も確認します。