Linux seccomp-BPF:システムコールフィルターの仕組みと限界
カーネルのseccomp-BPFがシステムコールを制限する方法、Docker既定プロファイルの範囲、単独ではサンドボックスにならない理由を解説します。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
コンテナ隔離でシステムコールが重要な理由
コンテナは通常、プロセスごとに別のOSカーネルを持つのではなく、ホストのカーネルを共有します。名前空間や資源制限で実行環境を分けても、アプリはシステムコールを通じて共通カーネルに処理を依頼します。seccompはその入口で利用できる呼び出しを絞り、カーネルに露出する範囲を小さくする手段です。カーネルの脆弱性をなくすものでも、コンテナを完全なセキュリティ境界にするものでもありません。Linuxカーネル文書もシステムコールフィルタはサンドボックスではなく、他の隔離・アクセス制御と組み合わせる必要があると明記しています。
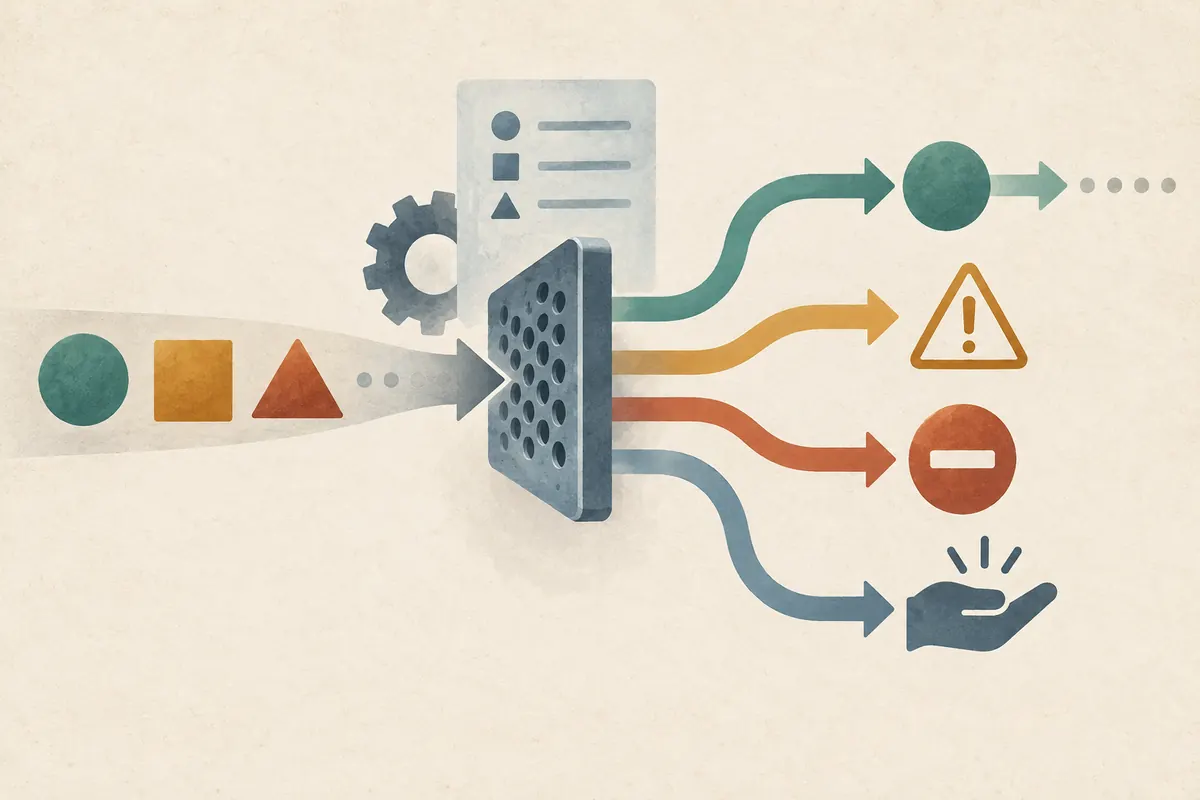
seccomp-BPFによる呼び出しの評価
フィルタはclassic BPFプログラムで、seccomp_dataに含まれるシステムコール番号や引数などを評価します。プロセスが呼び出しを行うとカーネルがフィルタを実行し、ALLOW、ERRNO、TRAP、KILL、TRACE、LOG、USER_NOTIFなどの動作を適用します。呼び出しの続行、エラー返却、シグナルや終了、トレーサへの通知、記録、ユーザー空間への通知はそれぞれ異なる結果です。すべてを単に「遮断」と呼ぶと実際の挙動が伝わりません。
フィルタの導入には前提条件があり、追加フィルタを重ねることもできます。カーネル文書は子プロセスへの継承やインストール時の権限条件を説明しています。また、システムコール番号だけでなくアーキテクチャも確認するよう警告しています。複数の呼び出し規約で番号が重なる環境では、番号だけの比較が誤判定につながる可能性があるためです。BPFはユーザー空間ポインターを直接参照できず、ポインター先の任意データを評価する汎用ポリシーエンジンではありません。
Dockerの既定プロファイルはDocker固有の説明
Dockerは現在の既定seccompプロファイルを許可リストとして説明しています。文書によると、300を超えるシステムコールのうち約44を拒否し、一定の保護と幅広い互換性の両立を目指します。この数と一覧は現在のDocker文書の説明であり、すべてのランタイム、ディストリビューション、リリースに共通する固定規則ではありません。ページにはptrace、reboot、setnsなどの例と、拒否する理由が記されています。ある呼び出しを除外しても、関連する危険への経路がすべてなくなるわけではありません。
動作にはカーネルとDockerビルドのseccomp対応も関係します。Dockerは別のプロファイルを--security-optで指定しない限り既定プロファイルを使うと説明し、既定プロファイルの変更を勧めていません。独自ルールを使う場合は、アプリの実際の呼び出し要件とホスト側の他の保護策を併せて確認します。Dockerの文書だけからKubernetesなど別の実行環境の既定値を推定することはできません。
専門家の視点:拒否規則を他の隔離層と一緒に確認する
seccompはシステムコール境界に小さく明示的な規則を設けられる点で有用です。一方、あらゆる引数の意味やアプリの情報流全体を判断する仕組みではありません。カーネル文書が述べるように、論理的な動作や情報の流れには他の強化策も必要です。Dockerのプロファイルは互換性も考慮しているため、許可リストの変更は露出範囲だけでなくアプリの挙動にも影響します。
見直しでは、どの呼び出しをなぜ許可・拒否するか、子プロセスにフィルタがどう適用されるか、エラー・記録・通知actionが運用上何を意味するかを確認します。変更を試すときは本番以外の環境で代表的な処理を実行し、互換性への影響を調べます。これは一つの隔離層と依存関係を理解するための確認であり、完全なセキュリティ監査や安全の保証ではありません。
出典
- Linux Kernel Documentation, “Seccomp BPF (SECure COMPuting with filters)” — フィルター入力、返却action、導入条件、アーキテクチャ上の注意点を示すカーネル文書。
- Docker Documentation, “Seccomp security profiles for Docker” — Docker既定許可リストとプロファイル適用範囲に関する製品文書。