Kubernetes probe設計:起動・再起動・トラフィック準備を分ける
startup・liveness・readinessがコンテナの終了と再起動、Serviceのエンドポイント状態に与える影響を分け、依存先障害や過剰な検査の運用リスクを説明します。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
Kubernetesのprobeはkubeletがコンテナを診断し、起動待ち、再起動、Serviceトラフィックへの参加を制御する仕組みです。startupは初期化の完了、livenessは再起動による回復が期待できる停止状態、readinessは要求を受け付ける準備を確認します。失敗時の作用が異なるため、意味を区別せず同じ検査先を使い回すべきではありません。
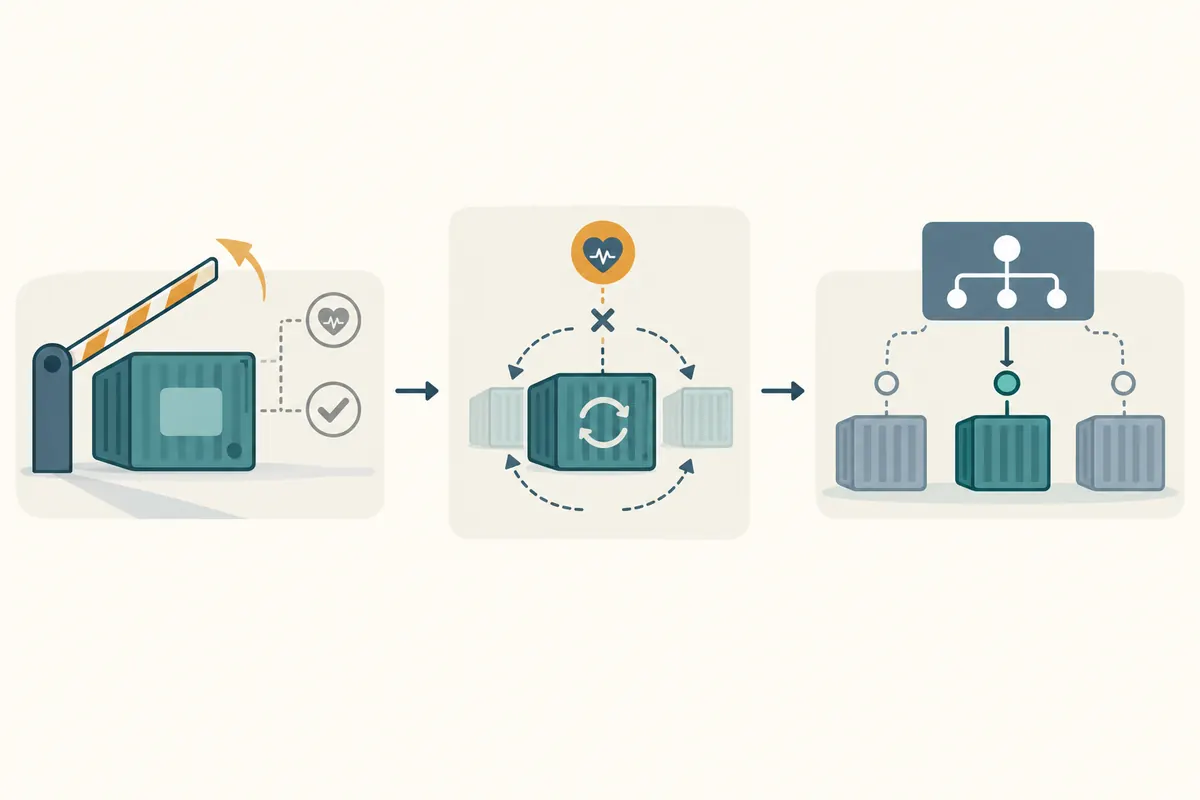
各probeが変える動作
Startup probeはアプリケーションの初期化中、livenessとreadinessの検査を開始しないようにします。startupが成功すると他のprobeが動き始めます。設定した失敗回数に達するまでstartupが失敗すると、kubeletはコンテナを終了し、その後はPodのrestart policyに従います。起動に時間がかかるアプリケーションでは、startupの周期とfailureThresholdで初期化時間を許容しつつ、起動後のliveness間隔を過度に緩めずに済みます。
Liveness probeは、プロセスが動作中に見えてもデッドロックなど自力回復が難しい状態を検出したい場合に使います。失敗するとkubeletがコンテナを終了し、再起動の挙動はPodのrestart policyで決まります。障害時にプロセス自身が終了し、ポリシーにより再起動されるなら、別のlivenessが不要な場合もあります。一時的な依存先障害をローカルの停止とみなすと、正常なコンテナまで繰り返し再起動するおそれがあります。
Readiness probeはコンテナが現在要求を受けるべきかを示します。失敗するとコンテナはNot Readyとなり、対象Podは一致するServiceの通常のトラフィック選択から外れます。Readinessはコンテナを再起動しません。初期データの読み込み完了など、意図する要求を実際に処理できる状態かを表す条件に使います。内部の警告すべてを失敗条件にせず、提供可否に関係する状態を定義してください。
検査方式とタイミング
KubernetesはHTTP、TCP、gRPC、exec方式をサポートします。HTTP probeはPod IPの指定ポートとパスへGETし、200以上400未満の応答を成功とします。TCP probeはポートが接続を受け入れるか確認するだけで、アプリケーションが正しい応答を返せることまでは示しません。gRPCはhealth-checking protocolを使い、execはコンテナ内コマンドの終了結果を確認します。検査したい状態を最も適切に表す方式を選びます。
periodSeconds、timeoutSeconds、failureThreshold、successThreshold、initialDelaySecondsが検査間隔と判定時間を決めます。startup probeを設定すると、成功するまでlivenessとreadinessの遅延計算は始まりません。間隔が短すぎると一時的な遅さを障害と誤認し、長すぎると再起動やトラフィック除外が遅れます。全コンテナに同じ厳しい値を使わず、実測した起動時間と回復時間に合わせます。
Kubernetes文書は、exec probeが毎回プロセスを生成するため、高密度のPodで短い間隔を使うとノードCPUの負荷になり得ると注意しています。軽量なHTTPやTCPの信号で要件を満たせるか検討し、probeごとに高価なDBクエリや複数の外部依存先への巡回を行わないようにします。Probeはkubeletの動作を決める診断であり、広範なサービス監視の代わりではありません。
依存先障害とreadinessの境界
プロセス自体は動作していても、必須のバックエンドが利用できない場合があります。Kubernetes文書は、バックエンドへの厳格な依存がある場合、livenessをアプリ自体の状態に、readinessを必須バックエンドの利用可否にも対応させる方法を示しています。readiness失敗は通常トラフィック選択に使われるPodとServiceのエンドポイント状態を変える信号です。既存接続を切断したり、すべてのプロキシで同時に経路が変わったりする保証ではありません。
遠隔依存先のすべての遅延をlivenessに含めると、共有バックエンドの障害が複数コンテナの同時再起動へ広がる場合があります。要求処理に不可欠な依存先と、一時障害時に要求を拒否するか保留するかを決め、その判断に沿ってreadinessの範囲を絞ります。利用者に見える失敗と原因の調査はprobeとは別の監視で続けます。
実務家の視点:症状と原因を分ける
Google SREの監視章は、利用者から見える症状と根本原因を区別し、外部からのblack-box信号と内部状態のwhite-box情報を併用する考え方を示します。probeではreadinessを「要求を受けるべきでない」状態に、livenessを「再起動が適切なローカル状態」に絞るのがこの考え方に沿います。遠隔依存先のすべてをlivenessに含めると、依存先の障害で正常なPodまで再起動され、復旧を難しくする場合があります。
起動遅延、readiness失敗、回復可能なプロセス停止を個別に試験します。Pod状態、Serviceのトラフィック選択、restart policyに沿った再起動を観察し、原因が解消した後に信号が戻ることも確認してください。利用者の症状や原因分析にはサービスレベル指標と外部監視を別に保ちます。probe成功は設定した診断が成功したという意味で、全機能や依存先すべての正常性を証明するものではありません。probe動作はKubernetes文書に、監視の区別はSRE章に基づきます。