Intl.SegmenterでUnicode文字境界を分割する
UTF-16コード単位、コードポイント、書記素クラスタは異なる単位だ。Intl.Segmenterはlocale別の境界を返すが、意味解析や画面上の表示幅までは判定しない。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
「一文字」はUTF-16コード単位、Unicodeコードポイント、人が一単位と感じる書記素クラスタのいずれを指すかで異なる。Intl.Segmenterはlocaleに応じた書記素・単語・文の境界を扱うが、字形や意味を解析するものではない。ECMA-402 Unicode UAX #29
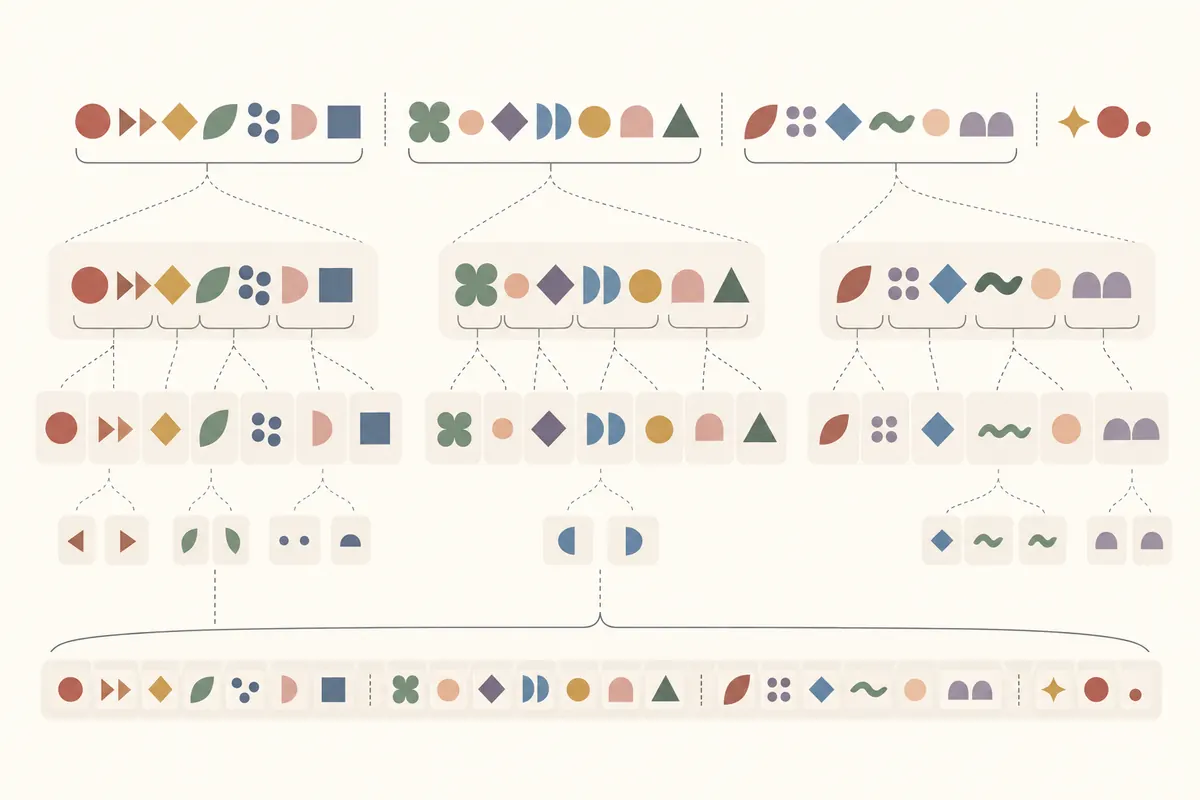
概念図であり、実行結果やブラウザー測定ではない。
「文字」には異なる単位がある
JavaScript文字列はUTF-16コード単位で扱われるため、lengthや単純な添字は読者が感じる文字数とは一致しない。コードポイントが複数のコード単位を使う場合があり、基底文字と結合記号や複数コードポイントの絵文字が一つの表示文字を構成することもある。コード単位、コードポイント、書記素クラスタを区別する。書記素クラスタは人が一文字と感じる単位の近似だが、画面上の字形や幅を保証しない。Unicode UAX #29
Intl.Segmenterの戻り値
Intl.Segmenterはlocaleとgranularityを指定して、grapheme・word・sentenceの境界で文字列を分割するJavaScript APIだ。たとえば new Intl.Segmenter("ja", { granularity: "word" })を作り、segment(text)を反復する。各結果にはsegment、入力文字列、開始位置のindexが含まれる。indexは元文字列のUTF-16コード単位オフセットだ。word分割ではisWordLikeが付くことがあるが、すべてのgranularityに共通する属性ではない。ECMA-402 MDN
目的に合うgranularityを選ぶ
結合文字や複合絵文字の途中で切らない処理にはgrapheme、検索や移動のための単語境界にはword、文の候補境界にはsentenceを使う。結果には空白や句読点も含まれるため、単語数を数える場合はすべてのsegmentを数えず、word-likeでない項目を除く。isWordLikeは境界の分類であり、品詞、語幹、翻訳、意味解析を返すものではない。Unicodeの既定規則は調整可能で、あらゆる言語処理を代替するわけでもない。MDN Unicode UAX #29
indexを画面位置と混同しない
indexは元のUTF-16文字列内での位置であり、分割番号やコードポイント数、画面上の列位置ではない。前方に補助平面文字があれば、コード単位オフセットとコードポイント数は異なる。フォントの字形形成、折り返し、双方向レイアウト、表示幅も別の問題だ。エディターが書記素を壊さずにカーソルを動かすには、境界情報に加えて描画レイアウトから画面座標を得る必要がある。ECMA-402 Unicode UAX #29
実務家の視点:localeと実行環境を確認する
空白で単語を区切れない言語では、localeに応じた境界や辞書の仕組みが重要になる。Unicodeは既定の書記素・単語・文境界を定めるが、一部の言語では追加の調整や辞書処理が必要だ。実際の結果は実行環境に搭載されたUnicode・国際化データにも左右され、新しい仕様書が全ブラウザーへ直ちに反映されるとは限らない。MDNのAPI資料によると、resolvedOptions()で実際に解決されたlocaleとgranularityを確認できる。Unicodeデータの版を示すものではないため、対象環境で対応状況と言語ごとの挙動を別途試す。実行していない環境の対応状況を断定しない。Unicode UAX #29 MDN
先頭のsegmentを画面から削除する場合でも、文字列オフセットと画面座標を同じ数値として扱ってはならない。API間でオフセットを保存・共有するなら、UTF-16基準であることも契約に含める。