Git packfile:オブジェクト保存、デルタ圧縮、インデックス
Gitのpackfileは複数のオブジェクトをまとめ、似た内容をデルタとして保存して重複を減らせます。pack indexによる検索、デルタ復元、転送用thin packとディスク上のpackの違いを解説します。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
Gitはコミット、ツリー、blobなどのオブジェクトを個別ファイルで保存できますが、リポジトリが大きくなると関連オブジェクトをpackfileにまとめます。pack内のオブジェクトは圧縮され、似たバージョンは基準オブジェクトとの差分(delta)で表して重複データを減らせる場合があります。読み出しにはpack indexやデルタの復元経路が関わるため、単にファイルを連結したアーカイブではありません。
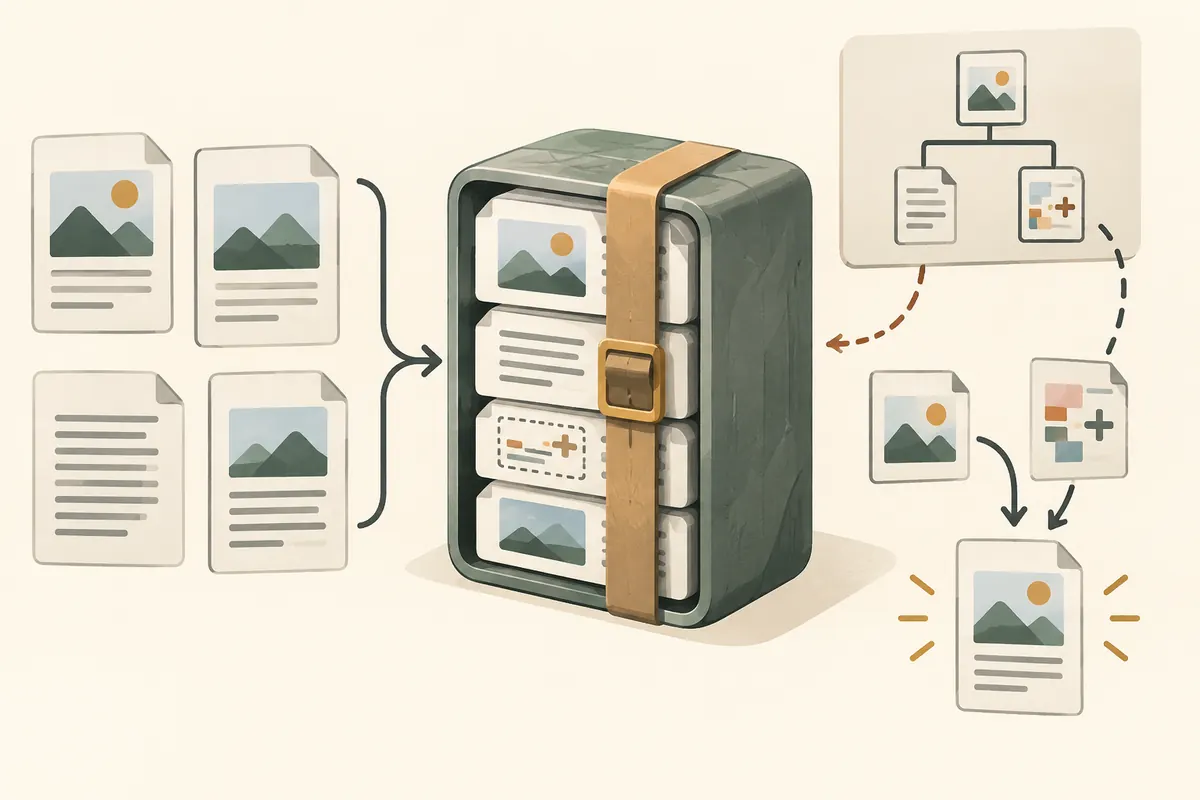
1. オブジェクトをpackにまとめる理由
Gitのオブジェクトモデルは内容を識別できる単位で保持します。loose objectは通常それぞれ別ファイルとして保存されるため、小さなファイルが多いプロジェクトや履歴の長いリポジトリではファイル数や重複内容が増えることがあります。packfileは多くのオブジェクトを圧縮した一つのまとまりに保存し、容量とファイル管理の負担を減らすのに使われます。pack化される時期は実行コマンドや保守方針によって異なります。
packにはヘッダー、オブジェクト数、型やサイズを示す各エントリー、圧縮データが含まれます。すべてのエントリーが他のオブジェクトを参照するわけではありません。直接復元できる形で保存するオブジェクトもあれば、適切な場合に基準オブジェクトとの差分を記録するものもあります。形式を知ると、ディスク容量と読み出し時の復元処理を一緒に理解できます。
2. デルタが節約するものと読み出しの処理
二つのファイルの版がよく似ている場合、全内容を繰り返す代わりに基準オブジェクトから再構成する命令を保存できます。packのデルタは基準のバイト範囲をコピーする操作と、新しいバイトを挿入する操作を使います。同じpack内の基準オブジェクトはオフセットで示すOFS_DELTA、オブジェクト名で示すREF_DELTAがあります。
デルタは重複データを減らせますが、読み出しには基準オブジェクトを探して命令を適用する作業が必要です。デルタが連鎖すると、古い基準から複数段階を適用することがあります。実際のコストはpackの配置、アクセスパターン、キャッシュ状態によるため、デルタ保存がすべての読み出しを速くするとは限りません。Gitのpack化や再packは容量とアクセス・復元コストの両方を考慮します。
3. pack indexとthin packの役割
pack indexはオブジェクト識別子とpack内のオフセットを対応付け、先頭から全体を読み進めずに目的のオブジェクトを探すために使います。公式形式文書にはpackと対になるインデックス形式も定められています。そのため調査や整合性確認ではpackとindexを合わせて扱います。
thin packは受信側に存在すると想定する基準オブジェクトを省いて、転送量を減らすための表現です。リポジトリに保存される完全なpackと混同してはいけません。thin packはpack外の基準を参照することがあるため、受信側で不足オブジェクトを補って自己完結するpackにする処理が必要です。転送時の処理が表現を補完し、ディスク上のpackは保存対象のオブジェクトについて有効な状態になります。
4. 専門家の視点:容量調査と保守
Gitのpackfiles解説は関連する版の差分を用いて容量を減らす例を示します。ただし、どのリポジトリでも一つの大きなpackが最善とは限りません。オブジェクトの参照頻度、リポジトリ規模、転送方法、再圧縮のCPUコストが関係します。packやindexを直接編集せず、Gitの整合性確認や保守コマンドを用いて、実際の容量と処理性能を観察してください。
容量が想定より大きいときは、まず容量を占めるオブジェクトを調べ、loose objectと既存packの内訳を確認します。再packや整理では、共同作業者が必要とするオブジェクトや参照にも配慮します。packfileの仕組みを知ればGitがすべての版を完全コピーするという誤解は解けますが、デルタ圧縮だけで一定の容量削減や速度向上を保証することはできません。