分散トレースのサンプリング:早く決めるか、トレースを見てから決めるか
ヘッドベースは早い段階で決めてデータ量を抑えますが、後から起きたエラーを逃すことがあります。テイルベースは多くのspanを見て選ぶ代わりに、バッファーやルーティングの運用負荷が増えます。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
トレースを全て保存するとデータ量と費用が増えるため、残す対象を選ぶサンプリングを使います。ヘッドベースは初めに判断し、テイルベースはspanが集まってからエラーや遅延、属性を評価します。後者は例外を狙えますが、エラートレースを必ず全て保存できるわけではありません。
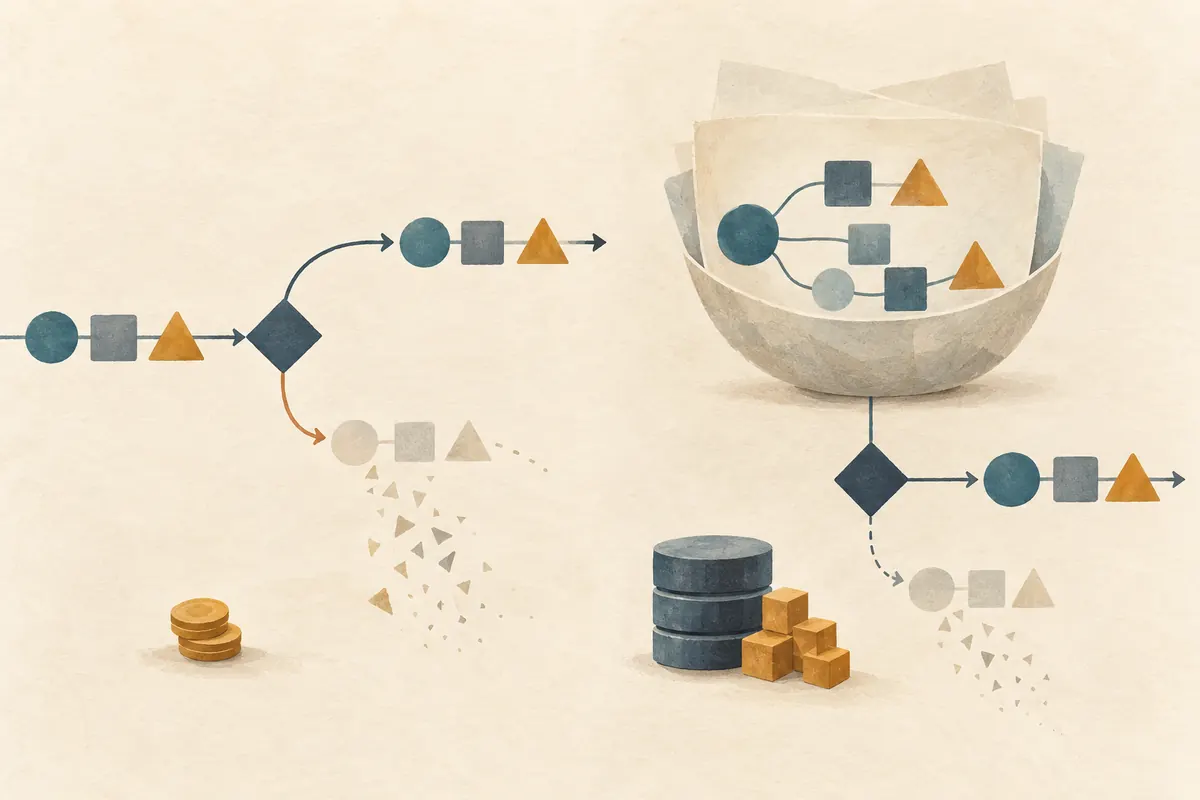
ヘッド方式は早く決める
ヘッドサンプラーはトレース全体を見る前に保存するかを決めます。一貫した確率サンプリングではtrace IDなどを使い、同じトレースのspanが同じ決定に従うようにできます。開始時に除外されたトレースは、後からエラーが起きても収集パイプラインに届かないことがあります。
この方式は比較的構成しやすく、後段に入るデータ量を抑えられます。多くの要求が似た正常処理なら、代表サンプルから通常時の動きを把握できます。一方、まれな失敗も同じ割合で除外され得るため、ヘッド方式だけでエラーを全て残す保証はできません。
テイル方式は集まったspanから判断する
テイルサンプラーはトレースの全て、または大部分のspanを考慮して選びます。全体の遅延、エラー状態、特定spanの属性など、後から分かる条件を使えます。エラーや遅延の条件に合うものを高い割合で残し、通常のものを低い割合にする方針が考えられます。
条件を使うにはspanが判断場所まで届く必要があります。SDKで既に除外されたデータをCollectorは復元できません。上流の割合を下げて後段で規則を適用すれば費用を抑えられますが、先に捨てたトレースは例外条件でも選べません。
トレースの組み立てにはメモリーと経路が要る
分散要求のspanは複数サービスから異なる時刻に到着します。必要な情報が集まるまで保持するため、資源使用量はトラフィック、遅延、判断までの待ち時間に左右されます。同じtrace IDのspanが別々のサンプラーに分かれると、各インスタンスが部分情報で判断する危険もあります。
Grafana Labsの2020年の事例は、Collectorを水平に増やす際、同じtrace IDのspanを一つのインスタンスへ送る設計を説明しています。当時のベンダー固有の実装事例で、現在の設定手順としては扱えません。一般には必要なspanを一つの状態保持経路に集め、不完全なトレースの処理を決める必要があります。
方針では取り逃す条件も記録する
エラーを優先する方針でも、全てのエラーを保存できるとは限りません。欠落span、キューの飽和、メモリー上限、判断タイムアウト、壊れたtrace context、Collector障害があると判断材料が揃わないことがあります。保存率とともに容量や不完全なトレースを監視します。
サンプリングは観測資源が限られるとき、どの証拠を残しやすくするかという選択です。利用状況の代表値と、まれな障害の原因を調べることは目的が異なります。率だけでなく、どのエラー・遅延・属性を残すか、どのケースを取り逃し得るかを明記します。
トラフィックと調査目的に合わせて選ぶ
まずデータ量がどの段階で費用になるかを調べます。パイプラインに入る前に減らすならヘッド方式、後から分かるエラーや遅延を見て決めるならテイル方式が候補です。ただしテイル方式にはバッファーと経路制御の容量が必要です。前段で除外したトレースは後から選び直せません。
小さな方針から始め、正常・失敗・遅延の要求がどれだけ残るか、組み立てられないトレースがどれほどあるかを測ります。負荷が増えた時のCollectorのメモリーやキューも確認します。SDKとCollectorの現行文書で機能や既定値を調べ、2020年の事例を現在の設定としてコピーしないでください。
テイルサンプラーのバッファーは判定を待つ間、spanを一時的に保持します。容量を超えた時に全て保存するか一部を除外するかは実装と設定によります。取り込み可能量、待機時間、欠落時の動作を現行文書で確認し、保持率だけから完全性を推測しないようにします。
専門家の視点:標本と全体の要求指標を併せて見る
サンプリングされたトレースは原因調査に役立ちますが、全要求を漏れなく記録するものではありません。要求数、エラー率、遅延分布など、トレースのサンプリング前に集計した指標と併せれば、まれな障害を取り逃していないか判断しやすくなります。方針を変える際は、保持率だけでなく全体件数と不完全なトレースの割合も比較します。