ブルームフィルターの偽陽性とRocksDBの設計選択
不在キーを素早く除外しながら偽陽性を許す理由と、RocksDBの形式・ビット予算による違いを解説します。
発行・訂正窓口:infostoa · 編集基準
この記事の個別の執筆者・専門査読者の情報は提供されていません。
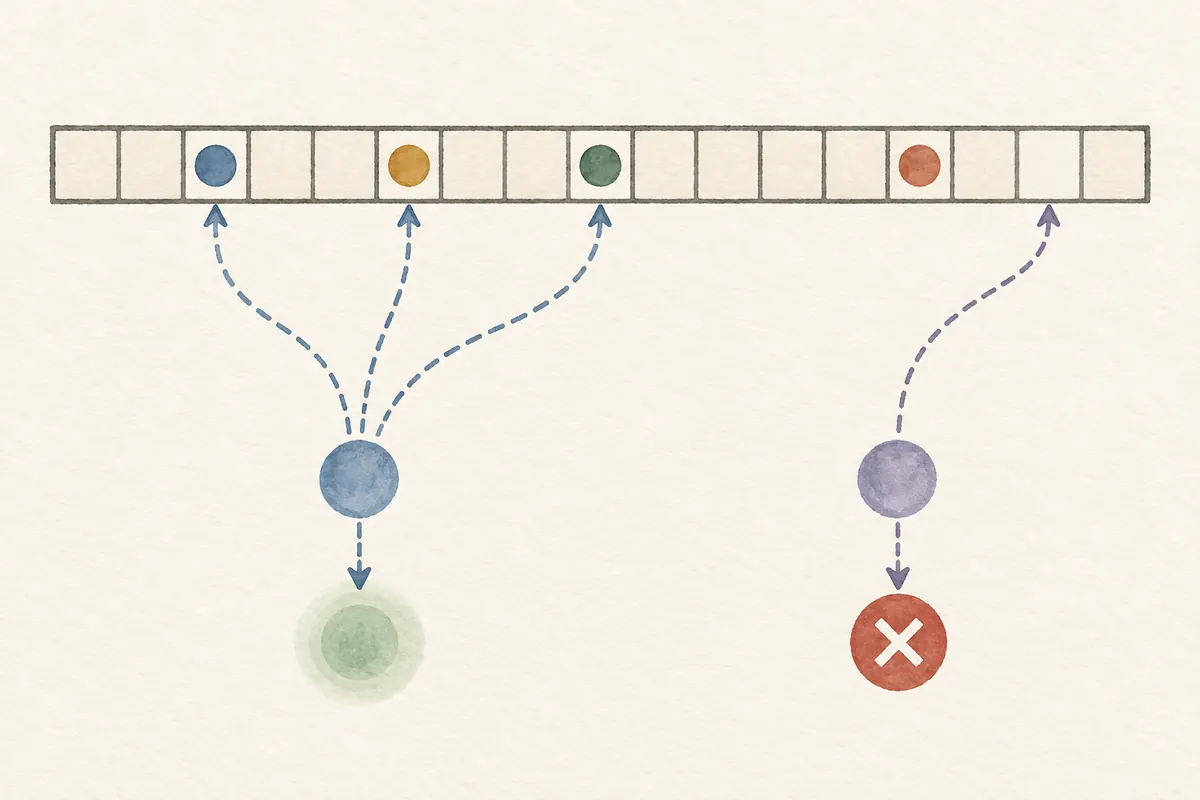
ビット配列と確率的な所属判定
教科書的な基本形では、mビットの配列を0で初期化し、登録する各要素のハッシュ位置k個を1にします。検索時に調べたビットのどれかが0なら、登録と検索の規則が一貫したフィルターは要素がないと判定できます。すべて1なら「存在する可能性がある」という意味にとどまり、保存データで確認が必要です。数式モデルは適切に分布するハッシュを仮定します。実装では位置計算を最適化することがあり、暗号学的ハッシュが必須という意味ではありません。
偽陽性確率とパラメーターのトレードオフ
登録後も特定ビットが0である確率を(1 − 1/m)^(kn)と近似すると、不在要素が調べたkビットすべてで1を見る確率はおよそ(1 − e^(−kn/m))^kです。これは要素数n、ビット数m、検査数kを置いた基本形の理想化近似です。このモデルでkを連続値として最適化するとk ≈ (m/n) ln 2となりますが、実装では整数のkに加えてハッシュ方式とメモリー配置を選びます。RocksDBの偽陽性率を別の実装やキー分布にそのまま当てはめず、実測してください。
RocksDBの形式が変える容量と検索のトレードオフ
RocksDBの文書はブロック型やSSTファイル全体を対象にするfull filterなど複数の形式を説明しています。full filterはファイル内キーのハッシュをより広く保持する代わりに、1回の検索で生じるキャッシュミスを減らす設計です。旧形式と新形式では容量や偽陽性の挙動が異なります。既存のSSTファイルは作成時の形式を使い、オプションは新しく作るファイルに影響すると説明されています。whole-keyとprefixのフィルターも検索範囲が異なるため、バージョンと設定の確認が必要です。
フィルタは補助索引であり、正本ではない
RocksDBでは、フィルタが「存在しない」と判定すれば不要なディスク読み込みを省ける一方、「存在する可能性がある」という結果の後には通常のキー確認が必要です。保存データや整合性確認の代わりにはなりません。削除・更新、prefixの設定、ブロック配置は静的なブルームフィルタの一般説明だけでは推測できないため、実際に使うRocksDBのバージョンとオプションを確認します。
要素数が増えたりビット配列が小さくなったりすると、同じ位置が設定される機会が増え、偽陽性も起きやすくなります。目標率を下げるには通常より多くのビットが必要で、ハッシュ回数を増やすと検索時の計算も増えます。確率式は適切なハッシュ分布を仮定した近似であり、実際のキーやストレージ実装も考慮します。
したがって、ブルームフィルタを選ぶ際は「誤り率を下げるためのメモリ」と「問い合わせごとの計算量」を一緒に比較します。要素数が事前の見積もりを超える場合は、設計時の率が維持されるとは限りません。追加・削除の扱いも実装ごとに確認し、肯定結果は必ず通常の検索で確かめます。
専門家の視点から見る選択と検証
Bloomの原論文から読み取れる運用上の要点は、誤りを許容できる箇所と、確定のための通常検索を残す箇所を分けることです。フィルターの「存在する可能性がある」という答えは、実データの存在を証明しません。偽陽性は保存先を検索して確かめます。偽陰性は有効なデータを見落とすため、登録・検索・更新の経路が前提を守るように設計する必要があります。この整合性要件は確率式を調整する前に決めます。
RocksDBの文書は形式ごとのメモリーや検索・キャッシュのトレードオフを説明しますが、どの環境でも特定形式が最速だとは述べていません。データの分割方法、whole-keyかprefixか、否定結果が実際にストレージ読み込みを省くかによって結果は変わります。設定名だけで性能を判断せず、使うバージョンとSST作成時の設定を確認しましょう。
評価では、想定するキー数と余分な検索のコストを整理し、異なるビット予算を代表的な肯定・否定クエリーで比べます。メモリー使用量、キャッシュミス、保存先への読み込み回数を観察し、全体の応答時間も有効化前後で比べます。フィルター自体のハッシュ計算やメモリーアクセスが、節約した処理を上回る負荷もあり得ます。
この仕組みを万能な高速化策ではなく、ワークロードに対する実験として扱ってください。通常のキー検索を維持し、許容できる誤りを決め、実際に動かすRocksDBの形式とバージョンを測定します。不在キーを安く除外するのが目的であり、正本を置き換えたり肯定結果を保証したりするものではありません。
出典・技術参考文書: Bloomの1970年原論文(Princeton大学アーカイブPDF), RocksDB Bloom Filterプロジェクト文書