HNSW 벡터 인덱스: 계층 탐색과 정확도·메모리 절충
여러 거리 규모의 근접 그래프를 이용하는 HNSW 원리와 구현별 M·ef 설정의 자원 및 검색 품질 절충을 설명합니다.
발행·오류 제보: infostoa · 편집 기준
이 글의 개별 작성자와 전문 검토자 정보는 제공되지 않습니다.
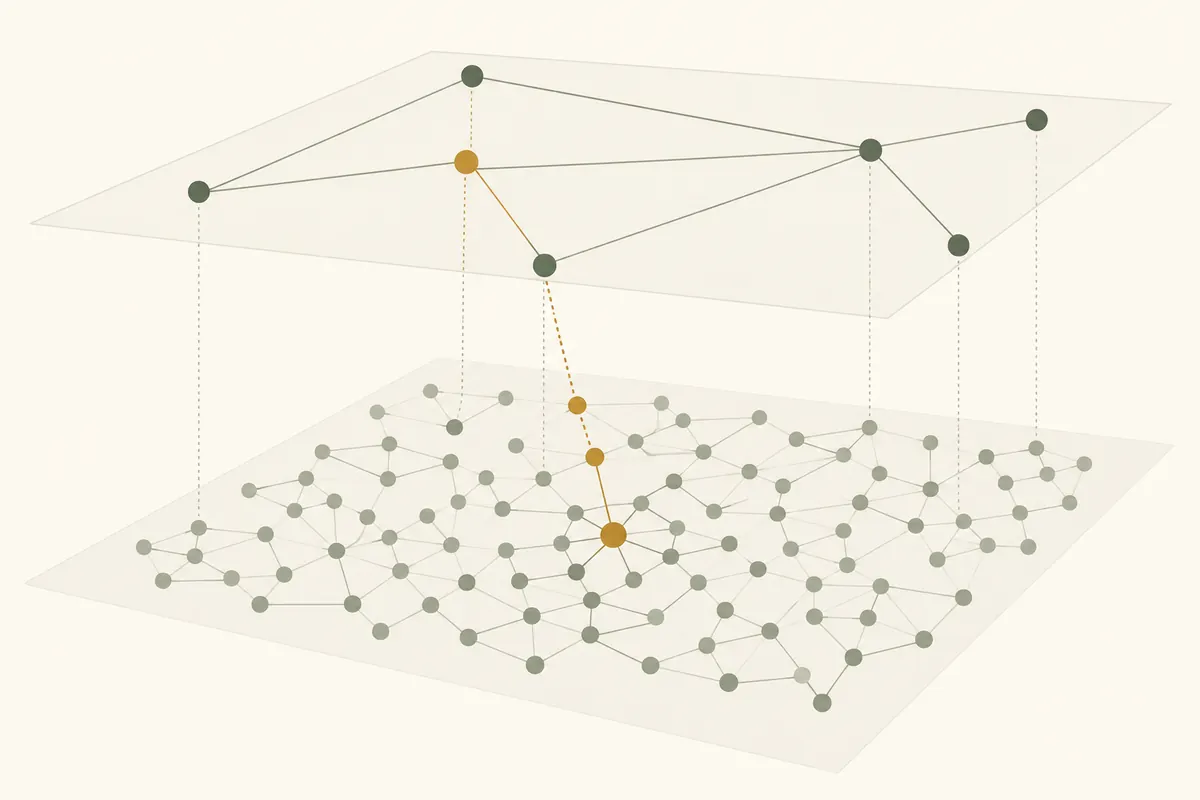
벡터 검색은 질의와 가까운 데이터를 찾습니다. 데이터가 많으면 모든 항목의 거리를 계산하는 정확 검색은 비용이 커질 수 있어 근사 최근접 이웃(ANN) 인덱스를 사용할 수 있습니다. HNSW는 근접 그래프를 여러 층으로 구성해 넓은 범위에서 후보를 찾고 점차 좁히는 그래프 기반 방법입니다. 반환된 결과는 근사치이므로 데이터와 설정에 따라 실제 상위 K개와 달라질 수 있습니다.
층마다 연결 거리 규모가 다르다
Malkov와 Yashunin 논문은 각 항목을 노드로 두고 근접한 항목 사이에 그래프 연결을 둡니다. 모든 노드는 최하층에 들어가고 일부는 확률적으로 더 높은 층에도 포함됩니다. 논문은 최고 층을 지수적으로 감소하는 확률로 선택해 위층일수록 노드가 적도록 합니다. 상층은 더 긴 거리의 연결을 제공하고 아래층으로 갈수록 촘촘한 근접 그래프를 탐색합니다.
고속도로와 골목길의 비유를 쓰면 상층은 관련 영역으로 넓게 이동하고 하층은 주변을 세밀하게 살핍니다. 다만 이 비유가 모든 질의의 최단 경로나 정확한 이웃 결과를 보장하지는 않습니다. 논문이 말하는 복잡도와 성능은 제안 알고리즘과 평가 데이터에 대한 주장입니다. 모든 차원, 데이터 분포, 거리 척도와 하드웨어에서 같은 결과가 보장된다는 뜻은 아닙니다.
질의는 상층에서 아래로 내려오며 후보를 좁힌다
탐색은 상층 진입점에서 출발해 질의와 가까운 이웃을 따라갑니다. 그 층에서 더 나은 후보를 찾지 못하면 아래층으로 이동하고, 이전 층에서 찾은 후보를 새 출발점으로 이용합니다. 최하층에서는 후보를 넓게 살펴 최종 K개를 고릅니다. 그래프가 유용하게 연결되어 있다면 저장된 모든 벡터를 매번 비교하지 않고도 가까운 영역을 찾을 수 있습니다.
근사는 계산량과 후보를 제한하는 과정에서 생깁니다. 링크가 부족하거나 데이터가 강하게 군집되거나 거리 척도가 목적에 맞지 않으면 필요한 이웃을 놓칠 수 있습니다. 임베딩 모델, 정규화, 거리 함수와 필터도 결과 해석에 영향을 줍니다. HNSW는 검색 인덱스이지 임베딩이 실제 의미를 잘 담았는지, 결과가 업무에 유용한지 검증하는 분류기가 아닙니다.
M과 ef는 구현별 조정 손잡이다
논문은 그래프 연결과 구축·검색 시 후보 폭을 조절하는 변수를 설명합니다. 널리 쓰이는 hnswlib는 M, ef_construction, 질의 시 ef를 제공합니다. 해당 라이브러리 문서는 M이 메모리 사용량에 큰 영향을 주고 정확도와 실행 시간에도 영향을 줄 수 있다고 설명합니다. ef_construction은 인덱스 구축의 탐색 특성을 조절하고, 질의 ef를 높이면 일반적으로 더 많은 후보를 살펴 정확도나 재현율이 나아질 수 있지만 검색은 느려집니다.
이 설명은 hnswlib 문서의 API 동작이지 모든 HNSW 구현이 동일한 파라미터와 기본값을 가진다는 뜻이 아닙니다. 저장 구조, 연결 상한, 병렬 구축, 필터 지원이 다를 수 있습니다. hnswlib README는 자기 API에서 ef가 K보다 커야 한다고 권하지만 이를 독립된 보편 규격으로 확대하면 안 됩니다. 실제 데이터와 대표 질의에 맞춰 정확 검색 결과와 비교해야 합니다.
속도와 정확도를 함께 검증한다
인덱스는 검색 시간만으로 평가하지 않습니다. 정확한 최근접 결과를 기준으로 재현율을 확인하고, 지연시간 분포, 메모리, 인덱스 생성 시간, 업데이트와 필터 조건도 기록합니다. 평균 재현율이 좋아도 드문 질의 종류나 작은 데이터 하위집단에서 결과 누락이 많을 수 있습니다. 임베딩 모델이나 데이터 분포가 바뀌면 이전 설정의 품질을 그대로 가정하지 말고 다시 측정합니다.
품질·비용 비교에서는 M과 후보 폭을 자동 개선 스위치가 아닌 절충값으로 다루세요. 논문의 로그 복잡도는 제안 방식의 분석이지 서비스 지연 보장이 아닙니다. 재현 가능한 평가를 위해 실제 질의 분포를 대표하는 정답 표본과 관련 결과의 판정 기준을 정하고, 필터 적용 후 후보가 적은 요청은 별도 집단으로 기록합니다. 임베딩과 거리 정의를 고정한 채 데이터·거리 척도·하드웨어·동시성·인덱스 버전, 재현율, 메모리, 구축 시간, 지연 분포와 느린 응답 비율을 함께 비교하세요. 변경한 설정이 재현율과 꼬리 지연에 준 영향을 기록하면 특정 요청 집단의 손실을 평균값이 가리는 일을 줄일 수 있습니다.