UTF-8 청크 경계에서 TextDecoder 오류 다루기
네트워크 청크가 UTF-8 문자 중간에서 나뉘어도 TextDecoder의 stream 옵션으로 상태를 이어 처리하고, 마지막 flush 오류를 확인합니다.
발행·오류 제보: infostoa · 편집 기준
이 글의 개별 작성자와 전문 검토자 정보는 제공되지 않습니다.
네트워크 응답의 바이트 청크 경계는 문자 경계와 일치하지 않을 수 있습니다. UTF-8 문자의 바이트가 여러 청크로 나뉘면 각 조각을 독립 디코딩하는 방식은 문자를 손상시킬 수 있습니다. Encoding Standard와 TextDecoder.decode() API 설명가 핵심 규칙을 설명합니다.
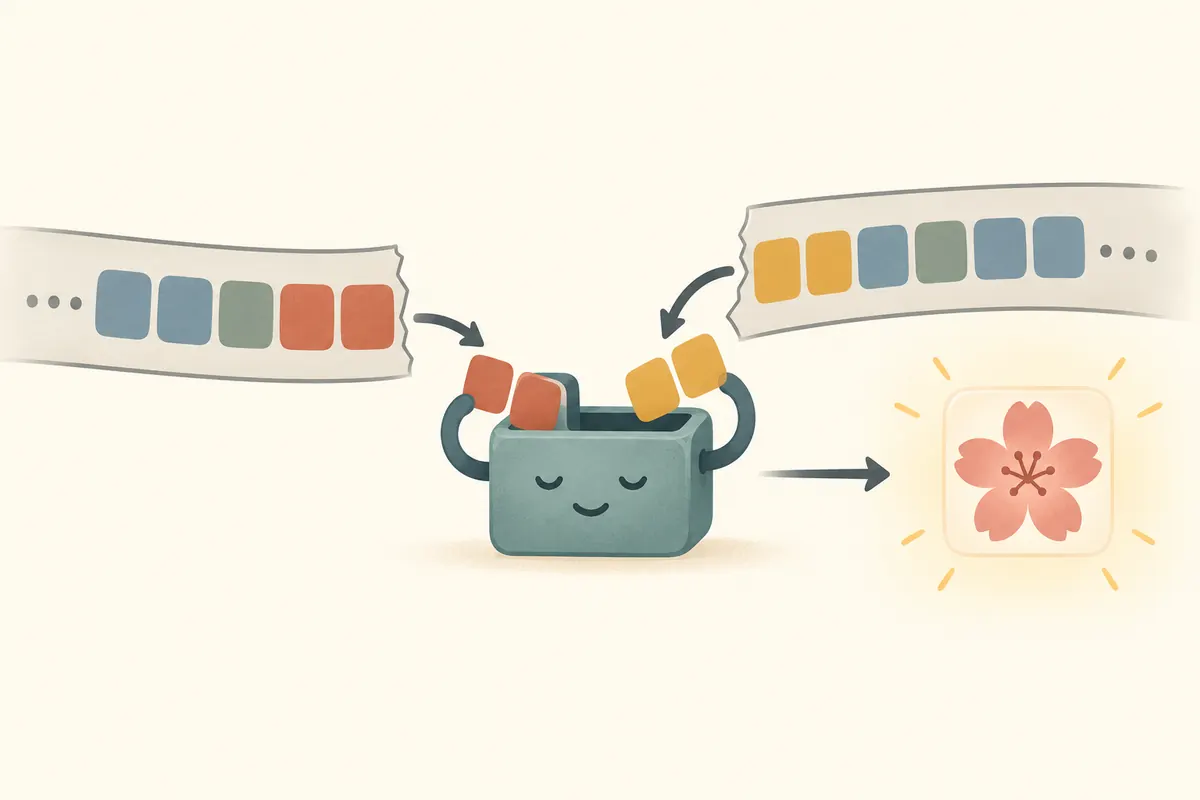
개념 그림이며 실제 요청이나 바이트 캡처 결과가 아닙니다.
조각마다 decoder를 새로 만들지 않기
하나의 TextDecoder 인스턴스에서 각 비마지막 청크를 decode(bytes, {stream:true})로 처리하면 불완전한 마지막 바이트 상태를 다음 입력으로 넘깁니다. stream:true를 생략하면 현재 입력이 끝난 것으로 처리되므로 청크마다 decoder를 새로 만들거나 기본 decode를 반복하지 마세요. ReadableStream.pipeTo() reference는 스트림 종료와 오류 전파의 맥락을 보완합니다.
마지막 청크에서 상태를 마무리
정상 입력 종료 때 decoder.decode()를 추가로 호출해 남은 상태를 flush합니다. 이 호출을 빼면 끝에 남은 불완전한 시퀀스를 놓칠 수 있습니다. 기본 fatal:false 모드는 잘못된 입력을 대체 문자로 처리할 수 있습니다. fatal:true를 선택하면 디코딩 오류가 예외가 되어 데이터 형식 문제를 조용히 대체하는 대신 호출자가 처리할 수 있습니다.
대체 동작을 문자별로 단정하지 않기
오류 모드가 replacement일 때 정확히 몇 개의 대체 문자가 나오는지는 입력 오류의 구조에 달려 있습니다. 손상된 바이트 하나마다 반드시 하나씩 나온다고 설명하지 마세요. 텍스트를 다른 시스템에 전달하거나 서명·파싱에 쓸 때는 허용할 입력 정책을 정하고 fatal 모드나 별도 유효성 검사 여부를 선택합니다.
TextDecoderStream을 고려할 때
TextDecoderStream은 ReadableStream의 바이트 청크를 문자열 청크로 바꾸는 변환 스트림으로 내부적으로 청크 경계를 처리합니다. 입력이 정상적으로 닫힐 때 마지막 미완성 상태를 flush하며, fatal 모드 오류는 스트림을 오류 상태로 만들 수 있습니다. 브라우저 지원과 파이프라인의 오류·취소 전파를 확인하세요. 응답 전체를 먼저 메모리에 모은 뒤 decode하는 방식과 달리, 이 API는 소비자가 청크 단위로 처리할 때 의미가 있습니다.
청크 처리 흐름을 한 인스턴스로 유지
읽기 루프는 응답 body reader에서 Uint8Array를 받아 같은 decoder에 전달하고, done이 true가 되면 마지막 decode()로 끝냅니다. 예를 들어 텍스트 줄을 파싱하는 경우에도 각 바이트 청크가 줄이나 문자 단위로 나뉜다고 가정하지 말고, 디코딩 후 남은 문자열 조각을 다음 결과와 합쳐 처리하세요. 이 내용은 API 동작을 설명하기 위한 예이며 실제 네트워크 호출을 수행했다는 뜻은 아닙니다.
스트림이 정상 EOF가 아니라 취소되거나 읽기 오류로 끝났다면 마지막 flush 결과를 완성 문서처럼 취급하지 마세요. 진단 로그에는 종료 이유, 마지막 decode() 호출 여부, fatal:true 예외 여부를 따로 남기면 전송 중단과 인코딩 오류를 구분하기 쉽습니다. 부분 데이터를 재시도·폐기·보고하는 정책과, 변환 스트림에서 pipeTo()의 오류·취소가 전파되는 방식도 확인하세요.