Intl.Segmenter로 유니코드 문자 경계 나누기
UTF-16 코드 단위, 코드 포인트, grapheme cluster는 다를 수 있다. Intl.Segmenter는 locale에 따라 grapheme·word·sentence 경계를 제공하지만, 단어 의미나 화면상의 글자 폭까지 판정하지는 않는다.
발행·오류 제보: infostoa · 편집 기준
이 글의 개별 작성자와 전문 검토자 정보는 제공되지 않습니다.
텍스트를 “문자 하나씩” 자르려 해도 코드 단위, 유니코드 코드 포인트, 사용자가 한 글자로 인식하는 grapheme cluster는 서로 다를 수 있다. Intl.Segmenter는 locale과 목적에 맞춰 grapheme·word·sentence 경계를 제공해 이 차이를 다루도록 돕는다. 다만 글자 모양이나 의미를 분석하는 도구는 아니다. ECMA-402 Unicode UAX #29
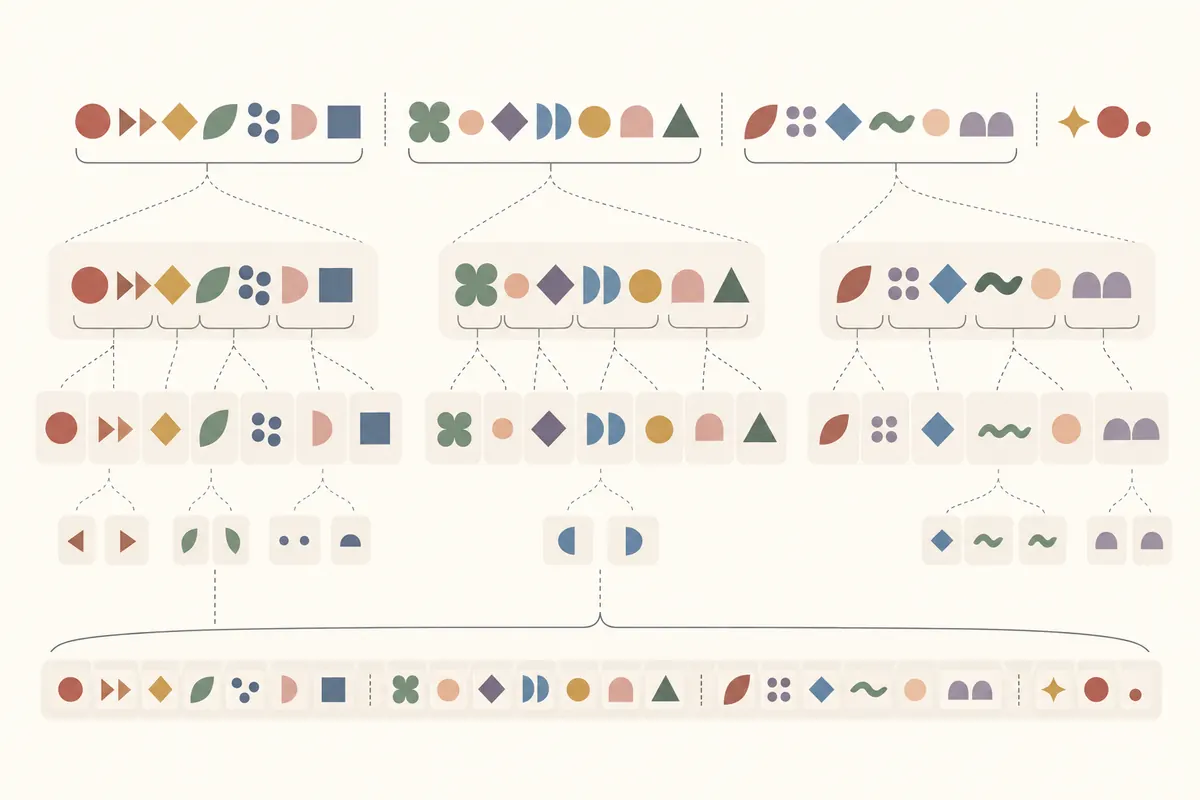
개념도이며 런타임 출력이나 브라우저 측정 결과가 아니다.
문자 단위가 서로 다른 이유
JavaScript 문자열은 UTF-16 코드 단위로 저장된다. length나 단순 인덱스가 사용자가 보는 글자 수와 같은 것은 아니다. 하나의 유니코드 코드 포인트가 여러 코드 단위로 표현될 수 있고, 결합 부호가 앞 글자에 붙거나 이모지가 여러 코드 포인트로 조합되기도 한다. 반대로 한 글자처럼 보이는 표시가 여러 코드 포인트를 포함할 수 있다. 따라서 코드 단위, 코드 포인트, grapheme cluster를 구분해야 한다. Unicode UAX #29
Intl.Segmenter가 제공하는 세분화
Intl.Segmenter는 locale과 granularity 옵션으로 텍스트를 grapheme, word, sentence 경계로 나누는 표준 JavaScript API다. new Intl.Segmenter("ja", { granularity: "word" })처럼 만들고 segment(text) 결과를 순회할 수 있다. 각 결과에는 segment 문자열, 원문, 시작 위치인 index가 포함된다. index는 UTF-16 코드 단위 위치다. word 세분화에서는 isWordLike가 제공될 수 있지만, 이는 모든 세분화 유형에서 공통으로 쓰는 표지가 아니다. ECMA-402 MDN
화면 이동·검색·문장 분리에 활용하기
커서를 “한 글자” 이동시키거나 문자열을 잘라낼 때 grapheme 경계를 이용하면 결합 문자나 복합 이모지 한가운데를 나누는 실수를 줄일 수 있다. 검색어를 단어 단위로 나누거나 문장을 훑어 요약 후보를 고를 때는 각각 word와 sentence granularity가 맞다. 다만 세그먼트 결과를 그대로 단어 개수로 세려면 공백과 문장부호 등 word-like가 아닌 항목을 걸러야 한다. isWordLike도 단어의 품사·어근·의미를 판정하는 NLP 결과가 아니다. MDN Unicode UAX #29
경계 인덱스와 표시 폭을 혼동하지 않기
반복 결과의 index는 원문에서의 UTF-16 오프셋이므로 segment 개수나 화면상의 열 번호가 아니다. 앞에 보조 평면 문자가 있으면 코드 단위 오프셋과 코드 포인트 개수가 달라질 수 있다. 글꼴, 줄바꿈, 양방향 텍스트, 조합 문자의 표시 폭도 세분화 경계가 직접 알려주지 않는다. 편집기에서 커서 위치나 선택 영역을 계산한다면 세그먼트 인덱스와 실제 렌더링 레이아웃을 별도로 다뤄야 한다. ECMA-402 Unicode UAX #29
전문가 관점: locale와 데이터 버전의 한계
언어별 단어 경계는 공백 규칙만으로 결정되지 않을 수 있어, locale에 따른 세분화와 사전 기반 처리가 중요하다. Unicode 규칙은 grapheme·word·sentence 기본 경계를 정의하지만, 일부 언어에는 추가 맞춤이나 사전 접근이 필요하다. 실제 결과는 엔진이 채택한 Unicode·국제화 데이터와 구현에 영향을 받으며 표준 문서의 최신 판본이 모든 브라우저에 즉시 반영되는 것은 아니다. MDN의 API 안내에 따르면 resolvedOptions()로 실제 적용된 locale와 granularity를 확인할 수 있다. 이를 Unicode 데이터 버전 표시로 혼동하지 말고, 배포 대상 런타임에서 지원 언어와 동작을 별도로 테스트해야 한다. Unicode UAX #29 MDN
예를 들어 화면에서 첫 세그먼트만 삭제하더라도, 문자열 인덱스와 화면 좌표를 같은 숫자로 취급하면 안 된다. 데이터베이스나 API에 오프셋을 저장한다면 그 값이 UTF-16 기준인지도 호출자와 공유해야 한다.