분산 트레이싱 샘플링: 먼저 고르는 방식과 나중에 고르는 방식
헤드 기반 샘플링은 트레이스 초기에 결정해 비용을 줄이지만 이후 오류를 보지 못할 수 있습니다. 테일 기반 샘플링은 전체 또는 대부분의 span을 살핀 뒤 선택하는 대신 수집·버퍼링과 운영 부담을 키웁니다.
발행·오류 제보: infostoa · 편집 기준
이 글의 개별 작성자와 전문 검토자 정보는 제공되지 않습니다.
트레이스를 모두 저장하면 데이터 양과 비용이 커질 수 있어, 어떤 요청을 남길지 고르는 샘플링을 씁니다. 헤드 기반은 트레이스 초기에 결정하고 테일 기반은 span이 모인 뒤 오류·지연·속성 등을 보고 결정합니다. 후자가 예외 상황을 겨냥할 수는 있지만 오류 트레이스를 100% 보장하지는 않습니다.
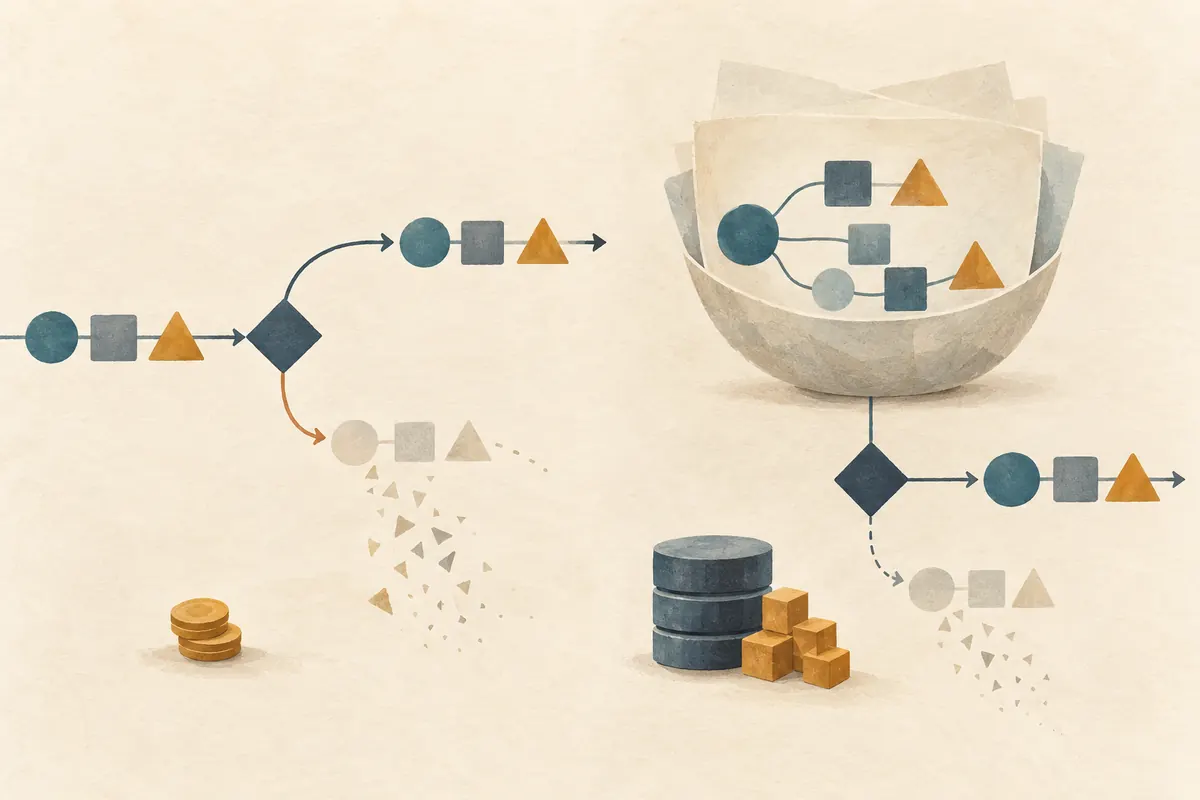
헤드 기반은 일찍 결정해 부담을 낮춘다
헤드 샘플러는 트레이스 전체 내용을 알기 전에 보낼지 버릴지 결정합니다. 일관된 확률 샘플링은 trace ID 등을 이용해 전체 트레이스가 같은 선택을 따르도록 합니다. 한 번 제외된 트레이스는 이후 서비스에서 오류가 생겨도 수집 파이프라인에 도착하지 않을 수 있습니다.
이 방식은 구성하기 쉽고 파이프라인에 들어오는 데이터 양을 줄일 수 있습니다. 성공적인 요청이 대부분인 시스템에서는 대표 표본으로 일반적인 동작을 살펴볼 수 있습니다. 그러나 실패가 드물면 오류가 있는 요청도 같은 확률로 빠질 수 있어 “오류는 모두 기록한다”는 조건을 헤드 샘플링만으로 보장할 수 없습니다.
테일 기반은 모인 span을 기준으로 선택한다
테일 샘플러는 트레이스에 속한 모든 span 또는 대부분을 살핀 뒤 결정을 내립니다. 전체 지연, 오류 상태, 특정 span 속성처럼 트레이스 후반에 드러나는 조건을 정책에 사용할 수 있습니다. 정상 트레이스는 낮은 비율로 남기고 오류·지연 기준에 해당하는 것은 더 높은 비율로 선택하는 식입니다.
정책이 실제 결과를 보려면 span이 판단 지점까지 도착해야 합니다. 애플리케이션 SDK에서 이미 제외된 데이터는 Collector의 tail sampler가 되살릴 수 없습니다. 앞단에서 선택률을 낮추고 뒤에서 규칙을 적용하면 비용을 줄일 수 있지만, 먼저 버린 요청은 더 이상 예외 조건으로 복구할 수 없습니다.
트레이스 조립은 메모리와 라우팅을 요구한다
분산 시스템에서 span은 여러 서비스에서 서로 다른 시간에 들어옵니다. 샘플러가 충분한 데이터를 볼 때까지 일부를 메모리에 보관해야 하므로 트래픽과 지연, 판단 대기 시간에 따라 자원 사용이 달라집니다. 같은 trace ID의 span이 서로 다른 sampler로 흩어지면 각 인스턴스가 부분 정보로 판단할 위험도 있습니다.
Grafana Labs의 2020년 사례는 Collector를 수평 확장할 때 같은 trace ID의 span이 같은 인스턴스로 모이도록 전달하는 설계를 설명합니다. 당시의 구체적인 구현 사례이지 현재 버전의 설정 안내가 아닙니다. 일반 원칙은 판단에 필요한 span을 같은 상태 저장 경로에 모으고, 불완전한 트레이스를 어떻게 처리할지 정하는 것입니다.
샘플링 정책은 놓치는 데이터도 기록한다
오류 트레이스를 우선 보존하는 정책도 모든 오류를 반드시 남기지는 않습니다. span 누락, 큐 포화, 메모리 제한, 판단 시간 초과, 잘못된 trace context, Collector 장애가 있으면 샘플러가 전체 정보를 받지 못할 수 있습니다. 따라서 보존 비율과 함께 누락·용량 지표를 모니터링해야 합니다.
샘플링은 “데이터가 사라지지 않는다”는 기능이 아니라 제한된 관측 자원으로 무엇을 더 자주 볼지 정하는 절충입니다. 대표 표본이 필요한 사용량 분석과 드문 예외 원인을 찾는 작업은 목적이 다를 수 있습니다. 정책을 하나의 숫자로만 정하지 말고, 어떤 오류·지연·속성을 보려는지와 놓칠 수 있는 사례를 명시합니다.
트래픽과 조사 목적에 맞춰 선택한다
먼저 데이터가 어디에서 비용을 일으키는지 확인합니다. 수집 이전에 전송량을 줄이려면 헤드 방식이 도움이 될 수 있고, 뒤늦게 드러난 오류를 보려면 tail sampling의 상태 저장·라우팅 부담을 감당할 수 있는지 평가해야 합니다. 두 방식을 조합하더라도 앞 단계에서 제외된 트레이스는 뒤에서 선택할 수 없습니다.
작은 정책부터 시작해 정상·오류·고지연 요청이 각각 어떤 비율로 남는지, span이 조립되지 않는 비율은 얼마인지 측정합니다. 트래픽 급증 때 Collector의 메모리와 큐가 어떻게 반응하는지도 확인합니다. 현재 버전의 정책 옵션과 기본값은 사용하는 SDK·Collector 문서를 다시 확인하고 2020년 사례 설정을 그대로 복사하지 않습니다.
전문가 관점: 표본과 전체 요청 지표를 함께 본다
샘플링된 트레이스는 원인 분석에 유용하지만 전체 요청을 빠짐없이 보여 주는 기록은 아닙니다. 오류율과 지연 분포처럼 표본 추출 이전의 집계 지표를 함께 살펴야 샘플러가 드문 장애를 놓쳤는지 판단할 수 있습니다. 정책 변경 전후에는 트레이스 보존 비율뿐 아니라 전체 요청 수와 불완전 트레이스 비율도 비교합니다.