분산 ID 생성 Snowflake: 대략적 정렬과 시계 역행 한계
Snowflake 계열 ID는 타임스탬프·작업자·시퀀스를 조합해 분산 생성과 대략적 시간 정렬을 돕습니다. 작업자 식별과 시계 역행이 고유성에 미치는 영향을 원본 구현과 운영 사례로 설명합니다.
발행·오류 제보: infostoa · 편집 기준
이 글의 개별 작성자와 전문 검토자 정보는 제공되지 않습니다.
Snowflake가 해결하려는 식별자 문제
분산 환경에서는 여러 노드가 동시에 레코드를 만들기 때문에 충돌 없는 식별자가 필요하다. Twitter 아카이브의 IdWorker.scala는 시간·데이터센터·작업자·시퀀스 값을 한 ID에 조합한다. 이 구조가 생성 시점마다 중앙 발급자를 요구하지 않게 하지만, 작업자 배정과 시계 조건은 운영자가 지켜야 한다. 저장소 README는 공개된 초기 버전이 은퇴했고 내부 버전은 Twitter 인프라에 의존하도록 다시 작성됐다고 밝힌다. 따라서 이 기사는 확인한 보관 코드에 한정해 설명한다.
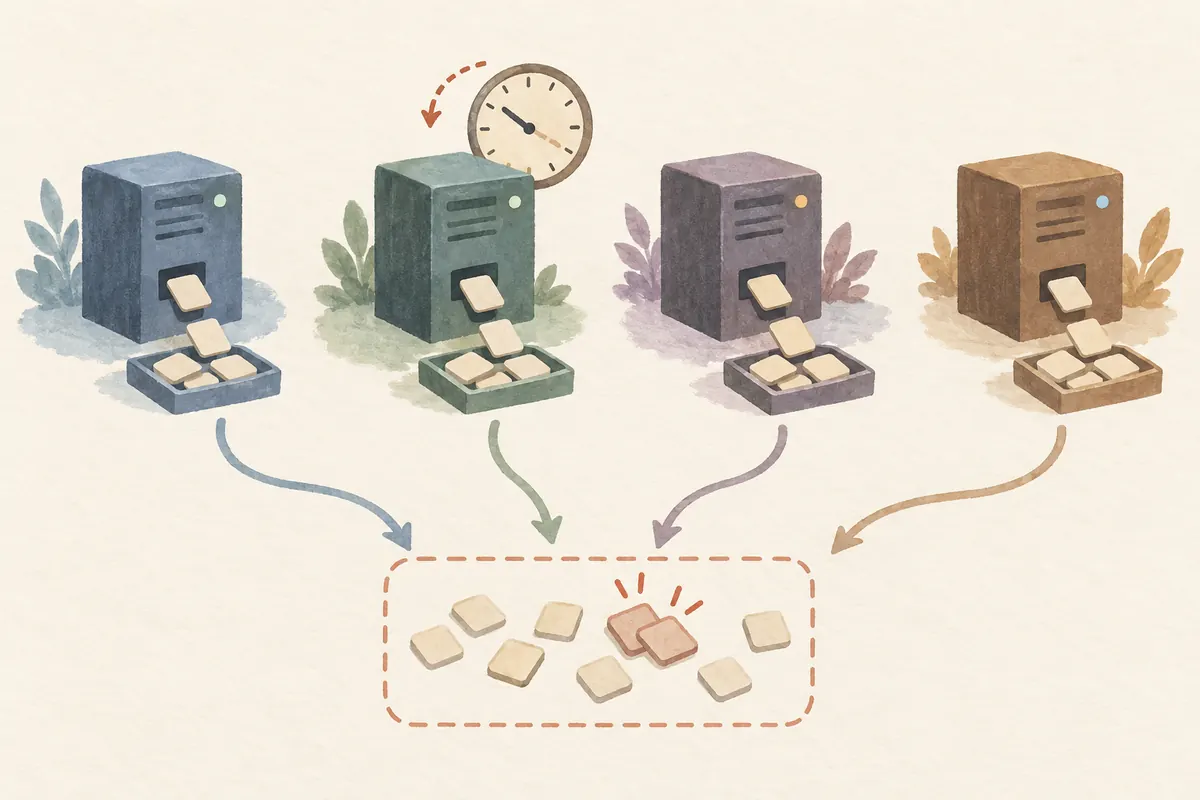
시간·작업자·시퀀스의 조합
원래 Snowflake 설계는 시간값, 작업자 번호, 시퀀스 번호를 한 정수형 식별자 안에 조합한다. 시간 성분은 대략적인 정렬을 돕고, 작업자 성분은 동시에 작동하는 생성기를 구분하며, 시퀀스는 한 작업자가 같은 시간 구간에 여러 ID를 만들 수 있게 한다. 중요한 점은 각 필드의 비트 수와 시간 단위, 기준 시점(epoch)이 구현마다 달라질 수 있다는 것이다. 현재 인터넷에서 Snowflake라는 이름을 쓰는 라이브러리가 원본의 레이아웃이나 약속을 그대로 따른다고 가정하면 안 된다.
2010년 보관 코드에서 시간 부분은 ID의 상위 비트에 들어가므로 서로 다른 밀리초의 ID를 대략 시간순으로 정렬하는 데 도움을 줍니다. 같은 밀리초 안에서는 worker와 sequence 비트가 결과를 나누므로 ID 대소가 여러 노드에서 발생한 사건의 인과 순서를 증명하지 않습니다. Discord 엔지니어도 자사 메시지 구조에서 Snowflake ID를 시간순 정렬 가능하다고 설명하지만, 이는 해당 데이터 모델의 사용 맥락입니다. 이 코드는 초기 공개 구현의 특정 동작을 보여 주며 모든 Snowflake 변형의 보장은 아닙니다.
원본 코드는 워커와 데이터센터 ID가 허용된 비트 범위를 벗어나면 초기화를 거부한다. 그러나 서로 다른 서버에 중복 값을 배정하지 않는 책임은 서비스 바깥의 구성 절차에 남는다.
고유성은 시간만으로 만들어지지 않는다
일반적인 조합에서 ID 충돌을 막으려면 생성 시점, 작업자 번호, 같은 작업자 안의 시퀀스가 중복되지 않아야 한다. 서로 다른 두 프로세스에 같은 worker 번호가 동시에 배정되거나, 복제된 설정을 여러 노드가 공유하면 시간값이 같을 때 충돌할 여지가 생긴다. 재시작, 컨테이너 이동, 백업 복원 뒤에 worker 식별자가 재사용되는 정책도 점검해야 한다. 이 부분은 운영 설정과 수명주기의 문제라서 비트 레이아웃만 확인해 고유성이 증명되지는 않는다.
시계 역행도 별도 위험이다. 한 노드가 과거보다 큰 시간을 기준으로 ID를 만든 뒤 시스템 시계가 뒤로 움직이면, 그 노드는 이미 사용한 시간 구간을 다시 만날 수 있다. 이때 시퀀스를 초기화하거나 오류 뒤 재시도하는 구체적 동작에 따라 중복이 생길 수 있다. 2012년 공개 이슈 #6은 당시의 코드 상태에서 시계 역행 오류보다 먼저 시퀀스를 초기화하면 같은 시간값을 다시 만날 때 중복이 생길 수 있다고 보고했다. 그러나 현재 읽은 snowflake-2010 태그 코드는 timestamp < lastTimestamp를 먼저 검사해 예외를 던진 뒤 시퀀스 처리에 들어간다. 따라서 이 이슈를 현재 태그의 동작으로 일반화하지 않는다. 버전·커밋별로 동작이 달라질 수 있어 실제 적용 코드 확인이 필요하다.
구현을 검증할 때 볼 불변조건
코드와 운영 설정을 함께 시험한다. 여러 생성기가 같은 worker 식별자를 배정받을 수 없는지, 같은 시간 단위 안에서 시퀀스 한도에 도달하면 생성기가 어떻게 동작하는지, 시계가 앞으로·뒤로 움직일 때 ID 중복이나 예외가 발생하는지 살펴본다. 재시작 이후의 ID와 타임스탬프 경계, 시간 기준 변경, 프로세스 복구도 테스트 대상이다. 오류를 반환한 뒤 상태를 어떤 값으로 보존하는지와 호출자가 같은 요청을 다시 보내는 방식도 확인한다.
테스트에서는 한 노드의 순차 생성만 확인해서는 충분하지 않다. 두 노드에 중복 worker ID를 잘못 주는 설정, 과거 타임스탬프 재방문, sequence overflow, 프로세스 재시작을 포함한 경계 사례를 구성해야 한다. 생성기가 오류를 냈다는 사실만으로 앞으로 같은 ID가 나오지 않는다고 가정해서도 안 된다. 애플리케이션이 충돌을 탐지하거나 원자적으로 기록하는 방식을 함께 검토한다.
전문가 관점: 정렬 편의와 엄격한 순서를 구분한다
Discord의 선임 스태프 소프트웨어 엔지니어 Bo Ingram은 서비스 메시지 저장 구조를 설명하면서 Snowflake ID가 시간상 정렬 가능하다고 소개한다. 실제로 Discord는 채널과 시간 구간을 조합한 데이터 저장 구조에 메시지를 배치하는 맥락에서 그 성질을 활용했다. 이 사례가 보여주는 실무적 가치는 ID의 정렬 가능성이 다른 저장·분할 설계와 함께 쓰인다는 점이다. ID 하나가 파티셔닝이나 데이터베이스 운영 문제를 해결하지는 않는다.
Twitter의 원 저장소는 2021년에 보관 처리됐으며 초기 버전은 은퇴했고 내부에서 사용한 버전은 다시 작성됐다고 README에서 설명한다. 따라서 오래된 코드를 최신 라이브러리의 보증서처럼 다루지 말고, 선택한 구현의 README·코드·버전별 clock rollback 대응과 worker 할당을 검증해야 한다. 필요하다면 전역 인과 순서를 별도 합의 프로토콜이나 데이터베이스 기능으로 정의한다.
출처
Twitter Archive: Snowflake source repository Bo Ingram, Senior Staff Software Engineer at Discord: How Discord Stores Trillions of Messages Twitter Archive Snowflake 2010: IdWorker.scala Twitter Archive Snowflake issue #6: Duplicate ids possible if clock moves backwards