Apache Parquet 사전 인코딩: 컬럼 청크와 페이지의 실제 역할
Parquet의 행 그룹·컬럼 청크·페이지 구조와 사전 인코딩을 설명하고, 형식의 가능성과 쿼리 엔진의 실제 성능을 구분합니다.
발행·오류 제보: infostoa · 편집 기준
이 글의 개별 작성자와 전문 검토자 정보는 제공되지 않습니다.
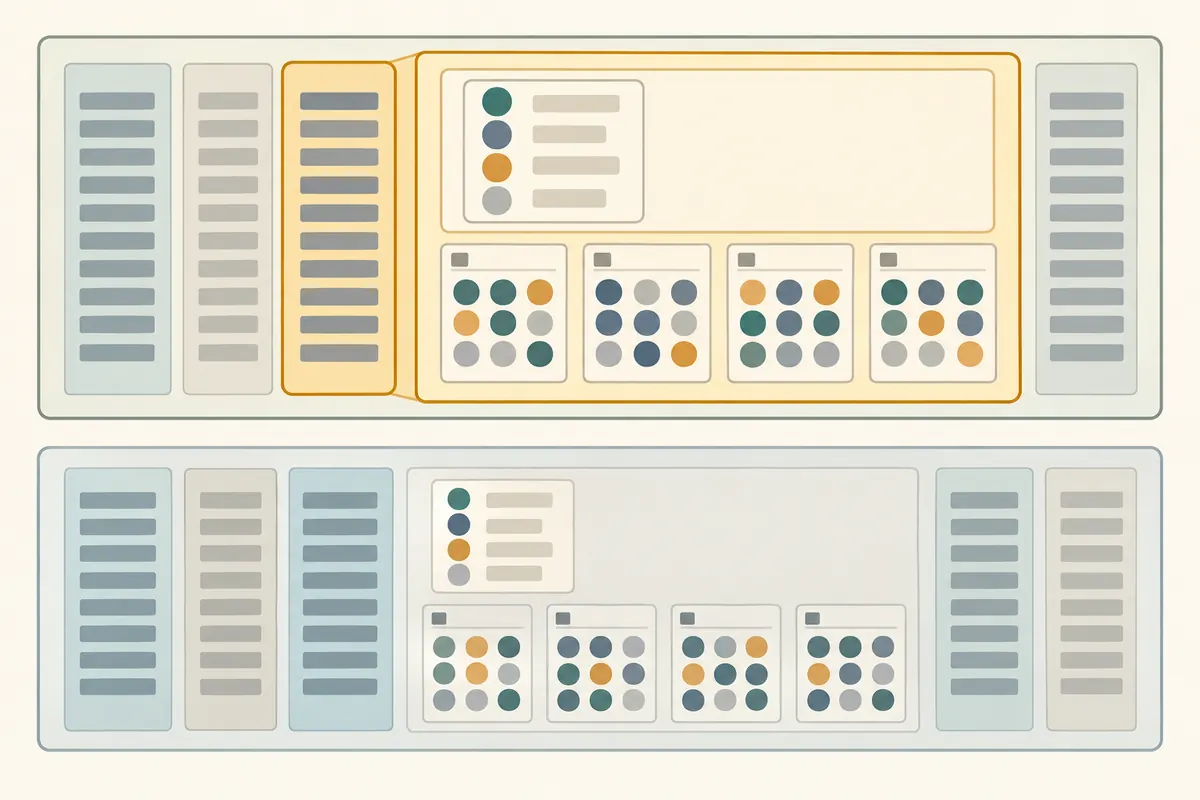
Apache Parquet은 데이터를 행 단위로만 저장하는 대신 컬럼 청크와 페이지로 나누어 담는 파일 형식입니다. 이 구조는 필요한 컬럼만 읽거나 값의 반복성을 활용하는 구현을 가능하게 합니다. 그러나 파일이 Parquet이라는 사실만으로 특정 쿼리가 빨라지지는 않습니다. 실제 읽기량은 파일 메타데이터, 선택한 컬럼, 행 그룹 크기, 인코딩, 압축, 그리고 사용하는 리더의 구현에 따라 달라집니다.
파일의 끝 메타데이터가 읽기 경로를 안내한다
Parquet 파일은 매직 넘버와 데이터 영역 뒤에 파일 메타데이터를 기록합니다. 이 메타데이터에는 행 그룹과 각 컬럼 청크의 위치가 들어 있습니다. 리더는 파일 전체를 처음부터 훑는 대신 메타데이터를 먼저 읽고 관심 있는 청크를 찾아갈 수 있습니다. 그래서 스키마와 파일 구조를 이해할 때 데이터 바이트뿐 아니라 푸터와 메타데이터도 함께 살펴야 합니다.
행 그룹은 논리적으로 행을 묶고, 각 행 그룹은 컬럼마다 하나의 컬럼 청크를 둡니다. 컬럼 청크는 다시 페이지로 나뉘며, 페이지는 인코딩과 압축이 적용되는 단위입니다. 이 계층을 구별하면 “컬럼형”이라는 말을 더 정확히 설명할 수 있습니다. 파일은 컬럼 중심으로 배치되지만, 행 그룹은 여러 컬럼의 같은 행 범위를 함께 묶어 쓰기와 읽기의 경계를 제공합니다.
사전 인코딩은 반복값을 인덱스로 바꾼다
사전 인코딩을 사용하는 컬럼 청크에서는 실제 값 목록을 사전 페이지에 두고 데이터 페이지에는 그 값을 가리키는 인덱스를 기록할 수 있습니다. 예를 들어 상태값처럼 같은 문자열이 자주 반복되는 컬럼에서는 긴 값을 매 행마다 저장하는 대신 작은 정수 인덱스를 저장할 수 있습니다. 인덱스는 RLE 또는 비트패킹 하이브리드 방식으로 표현될 수 있어 반복되는 인덱스의 기록량을 줄이는 데 도움이 됩니다.
사전 방식이 항상 이득인 것은 아닙니다. 값의 고유성이 높거나 값 자체가 짧으면 사전과 인덱스를 함께 저장하는 비용이 이득보다 커질 수 있습니다. Parquet 구현은 사전이 너무 커지는 상황에서 일반 인코딩으로 전환할 수 있습니다. 따라서 사전 인코딩 여부만 보고 압축률이나 읽기 속도를 단정하지 말고, 실제 데이터의 반복도와 사전 크기, 파일을 만든 writer와 읽는 reader의 지원을 확인해야 합니다.
페이지와 압축은 서로 다른 역할을 한다
인코딩은 값을 표현하는 방식이고 압축은 인코딩된 바이트열을 더 작게 만드는 방식입니다. 두 단계는 함께 작동할 수 있지만 같은 개념은 아닙니다. 페이지 헤더에는 인코딩과 압축에 관한 정보가 기록되어 리더가 데이터를 해석하도록 돕습니다. 파일을 분석할 때 “압축 코덱을 바꾸면 사전 인코딩도 달라진다”처럼 두 선택을 하나로 취급하면 원인을 잘못 짚을 수 있습니다.
페이지는 컬럼 청크 안에서 독립적으로 다룰 수 있는 단위여서, 리더는 관심 없는 페이지를 건너뛰거나 페이지 인덱스를 활용할 여지가 있습니다. 그렇더라도 모든 엔진이 모든 인덱스나 인코딩을 같은 방식으로 이용하는 것은 아닙니다. 데이터 생성 도구, 저장소 레이아웃, 쿼리 엔진의 조합을 기준으로 측정해야 하며, 형식 사양만으로 실행 계획이나 성능을 보장할 수 없습니다.
전문가 관점: 사양과 구현 동작을 분리해 읽기
Apache 문서는 파일 메타데이터가 청크 위치를 알려 주고 리더가 관심 컬럼을 선택할 수 있는 구조를 설명합니다. 형식 사양은 페이지, 인코딩, 사전 페이지의 배치 규칙을 정의합니다. 이 둘은 파일이 어떤 정보를 담는지 설명하지만, 특정 엔진이 어떤 청크를 건너뛰는지 또는 어느 정도 빨라지는지는 말해 주지 않습니다. 운영자는 파일 사양을 근거로 가능한 동작을 이해한 뒤, 자신의 writer·reader 조합에서 메타데이터와 실제 쿼리 계획을 확인해야 합니다.
성능을 확인할 때 기록할 것
컬럼 선택이 좁은 분석 쿼리는 컬럼 청크 단위 저장의 이점을 활용할 가능성이 있지만, 이는 데이터가 그 구조와 맞고 리더가 필요한 부분을 선택해서 읽을 때의 가능성입니다. 큰 행 그룹은 연속 읽기와 병렬화에 유리할 수 있는 반면, 세밀한 건너뛰기가 필요한 상황에서는 읽지 않아도 될 데이터가 늘어날 수 있습니다. 작은 행 그룹은 반대 방향의 절충을 만들 수 있습니다. 어느 쪽이 우월하다는 보편 규칙은 없으므로 데이터 크기, 작업 부하, 클라우드 저장소 비용, 동시 실행을 함께 비교해야 합니다.
실험에서는 입력 데이터와 스키마, 파일을 쓴 라이브러리·버전, 행 그룹 설정, 사전 인코딩과 압축 설정, 읽은 바이트, 실행 엔진·버전, 결과 정확성을 함께 기록합니다. 한 번에 여러 설정을 바꾸면 무엇이 영향을 주었는지 알기 어렵습니다. Parquet을 선택하는 이유는 구조가 제공하는 선택지를 활용하기 위해서이지, 파일 확장자 하나가 성능 약속이 되기 때문은 아닙니다.